
Преимущества SQL для запросов к данным
В этом руководстве показано, как аналитики и специалисты по обработке данных могут создавать более быстрые, надежные и удобные в обслуживании конвейеры обработки данных, чем универсальные скрипты на Python.
Введение: Скрытая цена «просто повторять одно и то же»
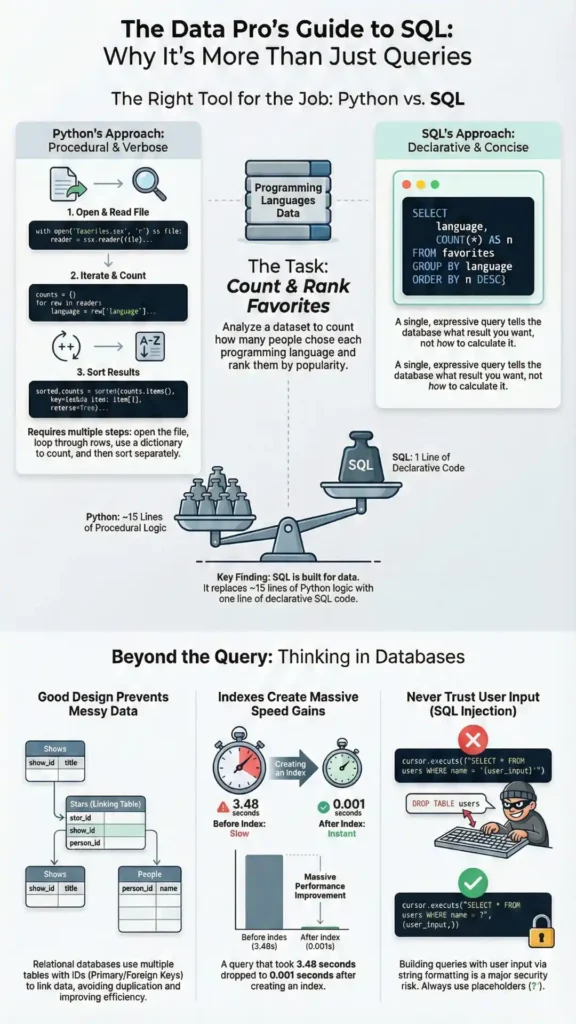
Для многих специалистов по работе с данными стандартный подход к новому CSV-файлу — это написание скрипта на Python. Мы открываем файл, перебираем строки и вручную создаем счетчики или списки, чтобы ответить на, казалось бы, простые вопросы. Хотя это и работает, часто приводит к медленному, ненадежному коду, который трудно поддерживать. Несколько измененных столбцов в исходном файле могут сломать весь скрипт. Ответ на немного другой вопрос означает переписывание сложных циклов и условных операторов. Этот императивный, пошаговый подход скрывает более мощный, элегантный и эффективный способ работы с данными. Используя специализированный язык, мы можем легче выражать сложные вопросы и заменить 17 строк ненадежного кода на Python одной декларативной строкой SQL.
Главный вывод 1: Сделайте процесс сбора данных надежным.
Одна из наиболее распространенных уязвимостей в простом скрипте обработки данных на Python — это доступ к столбцам CSV-файлов по их числовому индексу, например: row[1]. This code is fragile because it makes a hard-coded assumption about the data’s structure. If a colleague opens the source spreadsheet and moves the second column to the third position, the script will either crash or, worse, silently produce incorrect results by processing the wrong data.
Более надёжное решение — использовать встроенные функции Python. csv.DictReader. Instead of treating each row as a list of values, DictReader treats it as a dictionary where the keys are the column headers from the first row of the file. This allows you to access data by its meaningful name (e.g., row['language']), not its arbitrary position. The code will now work correctly even if the columns are reordered, as long as the header names remain the same.
Связь с наукой о данных: Этот подход значительно повышает устойчивость конвейеров обработки данных к изменениям в исходных файлах. Он уменьшает количество неожиданных ошибок, минимизирует затраты на обслуживание и гарантирует, что результаты анализа основаны на правильных столбцах данных, повышая надежность всего рабочего процесса.
Вывод 2: Сдвиг в сторону декларативного мышления
Фундаментальное различие между Python и SQL заключается в парадигме программирования, которую они поддерживают. Python в первую очередь предназначен для... императив—вы говорите компьютеру как Чтобы получить ответ шаг за шагом, для подсчета любимых языков программирования из CSV-файла используется подход на Python, включающий инициализацию переменных-счетчиков, открытие файла, перебор каждой строки и использование if/elif statements to increment the correct counter. This process, which can take around 17 lines of code, is verbose and details a specific procedure.
SQL, напротив, является декларативный—вы заявляете почему Вы получаете нужный ответ, а механизм базы данных определяет наиболее эффективный способ его получения. Та же задача подсчета в SQL выполняется одним оператором: SELECT language, COUNT(*) FROM favorites GROUP BY language;. This query doesn’t specify loops or conditionals; it simply states the desired result: a count of entries for each language. This shift from describing a process to describing an outcome is a powerful mental leap.
Связь с наукой о данных: Декларативное мышление позволяет аналитикам более прямолинейно формулировать сложные вопросы, касающиеся данных, с меньшей вероятностью логических ошибок. Вместо построения сложных процедурных циклов вы можете сосредоточиться на определении необходимых данных, что приводит к более чистым, читаемым и точным запросам.
«…похоже, мы тратим ужасно много времени на создание этого кода, хотя было бы неплохо упростить его… было бы здорово иметь возможность ответить на этот вопрос очень быстро…» — Harvard CS50x 2025 (YouTube) — Лекция: SQL
Вывод 3: Хорошая форма данных не случайна.
Структура ваших данных существенно влияет на вашу способность правильно и эффективно их анализировать. Распространенная ошибка, проиллюстрированная на примере электронной таблицы для телешоу «Офис», заключается в неправильном хранении связанных данных. Один из неудачных вариантов дизайна — добавление нового столбца для каждой звезды (star1, star2, etc.), which is inflexible and doesn’t scale. Another flawed approach is to have a row for each star, repeating the show’s title (“The Office”) over and over again, creating massive data redundancy.
Решение заключается в базовой концепции базы данных, называемой нормализацияВместо одной запутанной таблицы вы разбиваете данные на отдельные таблицы для отдельных сущностей. Например, вы создаете shows table for TV shows and a people table for actors. You then create a third “join table,” stars, that links them together using their unique IDs (show_id и person_id).
Данная конструкция устраняет избыточность, заменяя длинные текстовые строки переменной длины, такие как «Офис», небольшими целыми числами фиксированного размера (например, 32-битным или 64-битным идентификатором). Такой подход значительно экономит место и повышает производительность.
Связь с наукой о данных: Нормализация предоставляет мощную ментальную модель для очистки и структурирования данных. Выявление и устранение избыточности в неструктурированных наборах данных (например, в электронных таблицах) помогает предотвратить аналитические ошибки и гарантирует, что агрегирования и объединения дадут правильные результаты. Это основополагающий шаг в подготовке данных для надежного анализа.
Вывод 4: Решение проблемы производительности в одну строку.
Медленные запросы являются серьезным узким местом в анализе данных, особенно на больших наборах данных со сложными взаимосвязями. Например, запрос на объединение трех таблиц для поиска всех телешоу Стива Карелла занял «раздражающе долгое» время — 3.483 секунды — во время лекции. Эта задержка возникает потому, что без указаний база данных выполняет линейный поиск — проверяет каждую строку в таблице для поиска совпадений.
Решение состоит в создании INDEX on the column being searched. An index is a special data structure, much like the index at the back of a book, that allows the database to find specific rows almost instantly without scanning the entire table. By running a command like CREATE INDEX name_index ON people (name), you instruct the database to build an efficient lookup structure (typically a B-tree). In the lecture’s example, creating two indexes reduced a query for Steve Carell’s shows from 0.215 seconds to just 0.001 seconds—a massive performance gain.
Компромисс заключается в том, что индексы занимают больше места в памяти и могут немного замедлить операции записи.INSERT, UPDATE, DELETE), as the index must also be updated. However, for read-heavy analytical workloads, the benefit to SELECT speed is almost always worth it.
Связь с наукой о данных: Понимание индексов дает специалистам по работе с данными простой и эффективный инструмент для борьбы с узкими местами в производительности. При медленных запросах к большим наборам данных создание индекса по отфильтрованным столбцам часто является первым и наиболее эффективным шагом оптимизации.
Вывод 5: Перестаньте доверять пользовательскому вводу.
Создание запросов путем вставки пользовательского ввода непосредственно в строку, например, с помощью f-строк Python, создает серьезную уязвимость безопасности, известную как атака SQL-инъекции. Это происходит, когда злоумышленник предоставляет входные данные, которые выполняются как часть самой команды SQL.
Классический пример — форма авторизации. Если код формирует запрос, подобный этому: f"SELECT * FROM users WHERE username = '{username}'", a user could enter a username of admin' --. The single quote closes the string, and the -- starts a SQL comment, causing the rest of the original query (including the password check) to be ignored. The database is tricked into logging the user in as ‘admin’ without a valid password. This is famously alluded to in the “Little Bobby Tables” webcomic.
Решение заключается в всегда используют параметризованные запросыВместо f-строк вы используете заполнитель (например, ?) in your SQL string. You then provide the user’s input as a separate argument. The database library ensures that the input is treated strictly as data and never as executable code, completely preventing SQL injection attacks.
Связь с наукой о данных: Это критически важная практика обеспечения безопасности для всех, кто создает интерактивные приложения для работы с данными, панели мониторинга или любые инструменты, которые запрашивают данные из базы данных на основе предоставленных пользователем фильтров или входных данных. Отсутствие параметризации запросов подвергает ваши данные и системы значительному риску.
Что подать заявку сегодня
- При чтении CSV-файлов в Python используйте
csv.DictReaderinstead of accessing columns by number. - Прежде чем писать цикл на Python для агрегирования данных, задайте себе вопрос: «Может ли это быть единичный случай?»
GROUP BYquery in SQL?” - Если вы видите, что одно и то же текстовое значение многократно повторяется в электронной таблице, рассмотрите возможность разделения данных на две таблицы, связанные уникальным идентификатором.
- Если
SELECTquery with aWHEREclause is slow, create anINDEXon the column(s) in theWHEREclause. - Никогда не используйте f-строки или конкатенацию строк для добавления пользовательского ввода в SQL-запрос. Всегда используйте заполнители.
Закрытие
Хотя для решения любых задач легко использовать универсальный язык программирования, такой как Python, эта лекция из курса CS50 демонстрирует, что фундаментальные концепции информатики предлагают мощные практические преимущества для работы с данными. Эта лекция — лишь часть всеобъемлющего цикла, демонстрирующего, как фундаментальные темы в области вычислительной техники напрямую повышают качество и эффективность анализа данных. Используя декларативный характер SQL, надежные принципы моделирования данных и возможности повышения производительности, специалисты по работе с данными могут писать код, который не только быстрее, но и надежнее и проще для понимания.
Какую из рутинных задач обработки данных, выполняемых вами в Python, можно было бы решить одним декларативным SQL- запросом?