
Структуры данных: руководство для специалиста по анализу данных
Эта статья поможет специалистам по работе с данными понять основные структуры данных, чтобы писать более быстрый и эффективный с точки зрения использования памяти код.
Распространенное узкое место в скриптах обработки данных, от медленных циклов проектирования признаков до неэффективных поисков, часто можно объяснить несоответствием между задачей и используемой базовой структурой данных. Основная причина этих проблем с производительностью часто кроется не в логике вашего кода, а в том, как данные организованы в памяти. Понимание этих структур — и их компромиссов — является фундаментальным навыком для написания эффективных и масштабируемых аналитических конвейеров. В этой статье будут обобщены ключевые уроки по структурам данных из известного курса CS50x Гарвардского университета, напрямую связывающие эти основы информатики с практическим миром анализа данных и науки о данных.
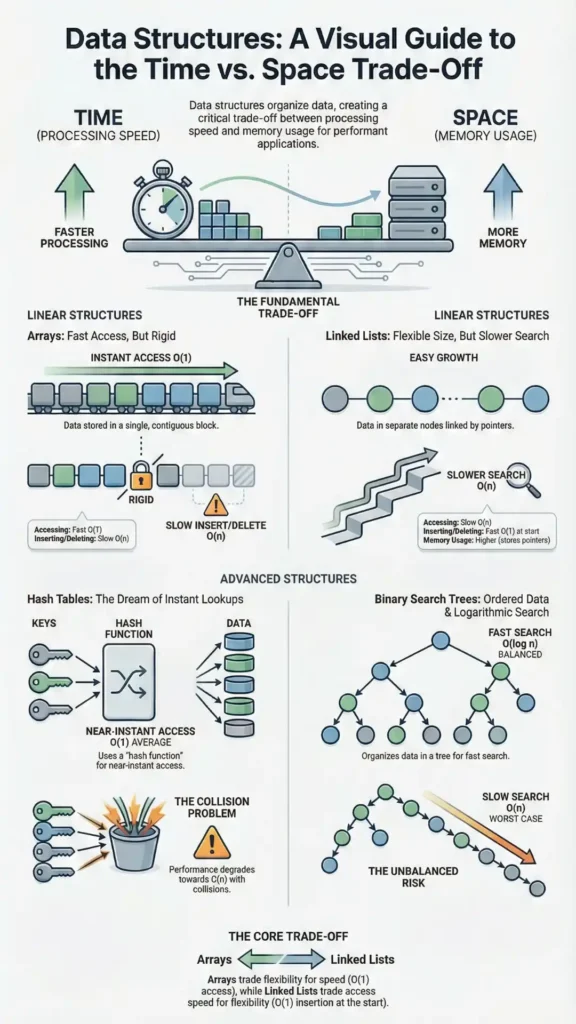
1. Массивы и их скрытая стоимость изменения размера
Массив — это простая структура данных, в которой элементы одного типа хранятся последовательно («континентально») в памяти. Такое последовательное расположение делает доступ к любому элементу по его индексу чрезвычайно быстрым. Однако у массивов есть важнейшее ограничение: их размер необходимо определить заранее.
Что происходит, когда нужно «увеличить» уже заполненный массив? Просто добавить новый элемент в конец, если это место в памяти уже занято, невозможно. Единственное решение — выделить совершенно новый, больший блок памяти, вручную скопировать каждый элемент из старого массива в новый, а затем освободить память, используемую исходным массивом. Этот процесс копирования — трудоемкая операция, занимающая «линейное время» — чем больше массив, тем дольше он длится.
Связь науки о данных
Многие распространенные инструменты работы с данными, такие как списки в Python, ведут себя как «динамические массивы». Хотя они, кажется, автоматически увеличиваются в размере, на самом деле они выполняют это дорогостоящее изменение размера. Для ускорения добавления элементов списки Python используют избыточное выделение памяти— резервирование дополнительного пространства — что приводит к амортизированному постоянному времени (амортизированное O(1)) для добавления. Однако вставка элемента в начало большого списка медленна не только из-за потенциального изменения размера, но и потому, что требует сдвига каждого последующего элемента на одну позицию вправо, что является прямой стоимостью O(n).
2. Связанные списки: обмен непрерывной памяти на гибкость.
Связанный список предлагает решение проблемы жесткого изменения размера массива. Вместо непрерывного хранения элементов, связанный список представляет собой последовательность «узлов», которые могут располагаться в любом месте памяти. Каждый узел содержит две вещи: фрагмент данных и «указатель» (адрес), который ведет к местоположению следующего узла. Это позволяет «объединять» доступные области памяти по мере необходимости.
Данная структура предполагает существенный компромисс:
- Потенциал роста: Список может динамически увеличиваться и уменьшаться без необходимости перемещения всех существующих элементов. Это позволяет более эффективно использовать фрагментированную память.
- Даунсайд: В целом, это требует больше памяти, поскольку для каждого элемента необходим дополнительный указатель для хранения адреса следующего элемента.
- Существенный недостаток: Вы теряете возможность быстрого бинарного поиска. Поскольку элементы хранятся не непрерывно, вы не можете мгновенно перейти в середину списка; вам необходимо обходить его по одному узлу за раз, начиная с самого начала.
Связь науки о данных
Рассмотрим журнал событий в реальном времени, где события могут нуждаться в добавлении или удалении из середины последовательности в зависимости от обновлений. Стандартный Python list would be punishingly slow for this, as each operation could require shifting many elements. A structure like Python’s collections.deque, however, is implemented using a doubly-linked list, providing fast O(1) appends and pops from оба концах.
3. Неочевидная истина: самый быстрый список составляется в обратном порядке.
При работе со связанным списком способ добавления новых элементов существенно влияет на производительность. Чтобы добавить новый узел в начало списка (препендинг), достаточно создать новый узел и обновить пару указателей в начале списка. Эта операция не зависит от общего размера списка.
Это делает добавление в начало списка операцией с константное время (O(1)) — невероятно быстрой. В отличие от этого, чтобы добавить новый узел в конец списка (добавление), необходимо сначала пройти весь список с начала, чтобы найти последний узел. Это делает добавление операцией linear time (O(n)) , которая становится все медленнее по мере роста списка.
Удивительный результат заключается в том, что наиболее эффективный способ построения связанного списка с нуля — это добавление каждого нового элемента в начало. Это означает, что если вы вставите числа 1, затем 2, затем 3, то итоговый список в памяти будет выглядеть так: 3 -> 2 -> 1.
Связь науки о данных
Это классический пример того, как, казалось бы, простой выбор — добавление в начало или в конец — может иметь огромные последствия для производительности (O(1) против O(n)). Это подчеркивает важность понимания временной сложности операций, которые мы ежедневно используем в скриптах очистки данных и проектирования признаков. Медленно работающий цикл может скрывать операцию с линейным временем выполнения, которую можно оптимизировать.
4. Бинарные деревья поиска: быстрый поиск, который может привести к вырождению.
Бинарное дерево поиска (БДР) пытается объединить лучшие стороны обоих миров: быструю скорость поиска, характерную для отсортированного массива, и динамическое изменение размера, свойственное связанному списку. Это дерево узлов, где каждый узел имеет до двух дочерних элементов. Структура определяется «свойством бинарного поиска»: для любого заданного узла все значения в его левом поддереве меньше, а все значения в его правом поддереве больше.
Это свойство позволяет осуществлять бинарный поиск, просто следуя указателям влево или вправо по дереву, достигая в среднем эффективной производительности поиска за логарифмическое время (O(log n)) . Однако у бинарного дерева поиска есть существенный недостаток. В «нестандартном случае», когда вы вставляете уже отсортированные данные (например, вставляете 1, затем 2, затем 3, затем 4), дерево становится полностью несбалансированным. Каждый новый узел просто добавляется справа от предыдущего.
В этом наихудшем сценарии бинарное дерево поиска «превращается в связанный список». Его производительность поиска снижается с логарифмического времени до медленного linear time (O(n)).
Связь науки о данных
Несбалансированное древовидное дерево поиска — это мощная метафора, иллюстрирующая разницу между средней и наихудшей производительностью. В науке о данных распределение и порядок входных данных могут существенно влиять на эффективность алгоритма. Именно поэтому индексы баз данных, которые часто основаны на древовидных структурах, требуют сложных алгоритмов «балансировки», которые постоянно реорганизуются и предотвращают возникновение наихудшего сценария.
5. Хэш-таблицы: практический путь к вычислению за постоянное время.
Хэш-таблица — это основная структура данных для реализации словарей, хранящих пары ключ-значение. Она мастерски сочетает массивы и связанные списки для достижения практически мгновенного поиска. Её основные компоненты:
- An массив из «ведр».
- A хеш-функция Эта функция принимает ключ (например, имя человека) и детерминированно преобразует его в индекс для массива.
- Связанные списки внутри каждого сегмента обрабатывать «коллизии» — случаи, когда два разных ключа хешируются к одному и тому же индексу массива.
Аналогия с полками для выдачи заказов в Sweetgreen, приведенная в лекции, прекрасно это иллюстрирует. Ваше имя в заказе — это ключ. Сотрудник, выбирающий полку по первой букве вашего имени (AE, FJ и т. д.), — это хеш-функция. Сама полка — это корзина (индекс в массиве). Несколько салатов на этой полке, которые вам нужно просмотреть, представляют собой связанный список для обработки коллизий. Хотя теоретически худший случай — это linear time (O(n)) если все ключи объединяются в один длинный связанный список, практическая производительность в среднем случае удивительно близка к константное время (O(1)).
«Да, технически хеш-таблицы представляют собой N, деленное на K, что на самом деле является арифметическим большим числом n, но на практике, если вы умны и грамотно используете хеш-функцию… вероятность коллизий, вероятно, будет настолько низкой, что даже если иногда процесс сводится к линейному времени, большую часть времени он будет действительно постоянным, то есть арифметическим большим числом единиц». — Harvard CS50x 2025 (YouTube) — Лекция: Структуры данных
Связь науки о данных
Хэш-таблицы — это основа работы словарей в Python.dict) and sets (set). This is why key lookups (my_dict['key']) and membership testing (item in my_set) are exceptionally fast. These structures are fundamental tools for performant data manipulation, creating lookup tables, aggregating data by category, and building features efficiently.
Что подать заявку сегодня
- Для поиска по ключу-значению всегда предпочтительнее использовать словарь/хеш-таблицу. Поиск по списку пар. Разница в производительности между O(1) и O(n) огромна на больших наборах данных.
- При оценке производительности следует учитывать порядок данных. Как видно на примере бинарных деревьев поиска, вставка отсортированных данных в определенные структуры может привести к наихудшему сценарию поведения.
- Подумайте, действительно ли ваши данные нуждаются в упорядочивании. Если вам нужны только быстрые поиски и проверки принадлежности элементов, то множество (на основе хеширования) гораздо эффективнее списка.
- Визуализируйте лежащие в основе операции. Если скрипт работает медленно, подумайте, не приводите ли вы к тому, что внутри цикла выполняется линейная операция O(n), не создавая непреднамеренно сложность O(n²).
- Учитывайте компромисс между временем и пространством. Хэш-таблица (подобная той, что используется в Python)
dict) consumes more memory than a list to store its hash values and pointers, but it buys you dramatically faster lookups—a trade-off that is essential to writing performant code.
Закрытие
Главная тема заключается в том, что каждая структура данных представляет собой компромисс между временем, пространством и сложностью реализации. Не существует единственной «лучшей» структуры, есть только наиболее подходящая для решения конкретной задачи. Далее лекция переходит к Python, языку, который абстрагирует многие детали ручного управления памятью, которые мы обсуждали. Однако принципы производительности остаются столь же важными, поскольку эти структуры по-прежнему работают «под капотом». О какой структуре данных, которую вы используете каждый день, вы теперь будете думать по-другому?