
Что специалисты по анализу данных забывают о памяти
Руководство для аналитиков и специалистов по обработке данных, помогающее писать более надежный, эффективный и предсказуемый код, понимая, как на самом деле работает память.
Введение: Ошибки, которых нет в вашей логике
У вас есть Питон Скрипт, который отлично работает на небольшом фрагменте данных, но аварийно завершается с непонятной ошибкой. MemoryError on the full dataset. Or maybe you’ve encountered a bug in a data pipeline that vanishes when you try to debug it step-by-step. These frustrating problems often have nothing to do with a flaw in your business logic and everything to do with a gap in understanding what the computer is doing “under the hood.”
Многие из этих сложных и непредсказуемых проблем коренятся в фундаментальных концепциях информатики, касающихся памяти. Понимание этих концепций — это не просто академическое упражнение; это практический навык для написания более качественного и надежного кода. Эта статья представляет собой обобщение материала лекции CS50x 2025 (Гарвард) по теме памяти, доступной на YouTube.
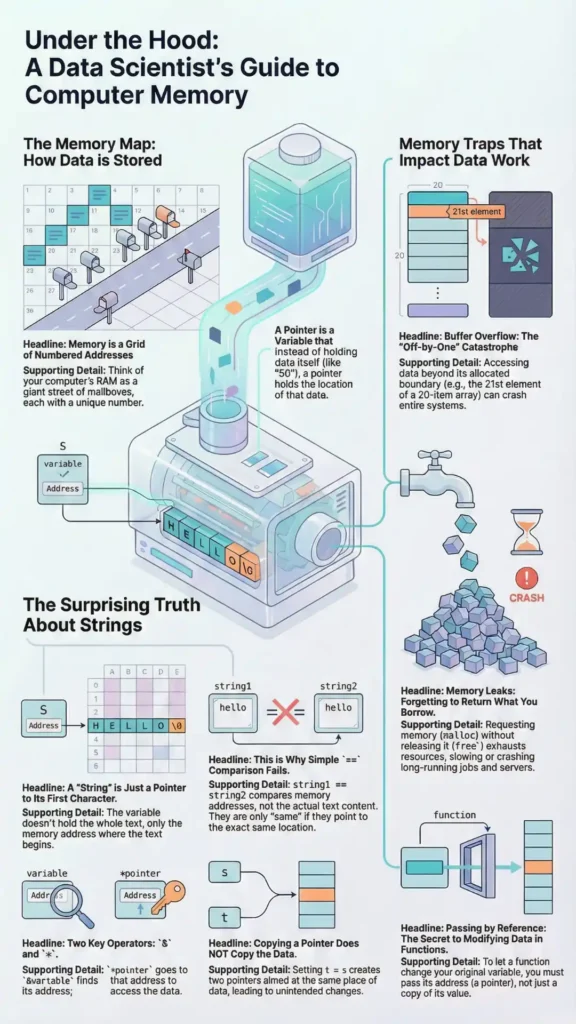
Вывод 1: «Струна» — это иллюзия.
Во многих вводных контекстах string is presented as a basic data type. The CS50 library, for instance, uses it as a helpful “training wheel” to get students started. However, in a foundational language like C, there is no built-in string data type. It’s an abstraction.
То, что мы называем строкой, на самом деле является char *—a pointer to a character. This pointer is simply the memory address of the первый символ в последовательности. Чтобы узнать, где заканчивается строка, в языке C используется специальное сигнальное значение: нулевой терминатор (\0), a byte containing all zeros. Functions like printf read from the starting address character by character until they hit this null terminator. Without it, the function would just keep reading into adjacent memory, causing unpredictable behavior.
Связь с наукой о данных: Эта концепция является предшественницей того, как высокоуровневые языки, такие как Python и R обрабатывают строки и другие данные переменной длины. Она объясняет, почему манипуляции со строками могут быть вычислительно затратными; система часто сканирует наличие точки завершения или управляет базовыми массивами. Для специалистов по анализу данных это имеет решающее значение при разборе необработанных текстовых файлов или работе с API; отсутствующий или некорректный байт-терминатор может привести к повреждению данных или ошибкам разбора, например, к неправильному прочтению строки в файле журнала и усечению важной информации об ошибке.
Вывод 2: Почему? == Can Lie About Equality
При сравнении двух целочисленных переменных в языке C с помощью ==, you’re comparing their values. But if you compare two string variables with ==, you are not comparing their content. Instead, you are comparing their memory адреса.
Если у вас есть две одинаковые строки, «high» и «high», но они хранятся в разных местах в памяти, то == operator will return false. Their content is the same, but their addresses are different. This is why C requires a special function like strcmp (string comparison), which performs a character-by-character check to determine if the strings’ values are truly identical.
Связь с наукой о данных: Это прямая параллель с концепцией идентичности объектов и равенства значений в Python. Используя is in Python compares memory addresses (identity), while == typically compares values (equality). For complex objects like Pandas DataFrames, even == can be ambiguous. This is why dedicated methods like pandas.DataFrame.equals() exist. The fundamental C behavior explains why you can’t just compare two DataFrames with a simple operator; you need a robust method that iterates through and compares their actual contents, just like strcmp does for C strings.
Вывод 3: Копия может оказаться всего лишь псевдонимом.
В языке C такая инструкция, как string t = s; might look like it’s creating a new copy of string s and naming it t. It is not. This operation does not copy the string’s content (the characters ‘H’, ‘I’, ‘!’, ‘\0’). It only copies the адрес первого символа строки.
Это означает обе переменные, s и t, now point to the exact same block of memory. They are two different names for the same underlying data. Consequently, if you modify the string using the variable t (for example, by capitalizing the first letter), you are also changing the string for s. There is only one string, and both variables point to it.
Связь с наукой о данных: В этом кроется корень проблемы «представление против копирования», которая часто сбивает с толку пользователей Pandas. Специалист по данным может отфильтровать DataFrame, присвоить его новой переменной и начать вносить изменения, полагая, что работает с независимой копией. Но если Pandas вернет «представление» (псевдоним, указывающий на исходные данные), он непреднамеренно изменит свой исходный набор данных. Это может привести к незаметным, опасным ошибкам, которые трудно отследить, поскольку исходные данные «загадочным образом» изменяются в результате операции, выполненной где-то еще.
«Когда вы используете оператор "равно" для сравнения двух строк… то есть сравниваете две символьные звезды, то есть сравниваете два адреса, очевидно, что они находятся в разных местах… нам нужно было решение этой проблемы, и поэтому мы ввели функцию stir comp, которая действительно правильно её решает». — Harvard CS50x 2025 (YouTube) — Лекция: Память
Вывод 4: Память — это ограниченный ресурс, которым необходимо управлять.
Когда программе требуется память во время выполнения — например, для хранения данных, считанных из файла, — она может запросить её у операционной системы. В языке C это делается с помощью функции, называемой malloc() (memory allocation), which asks for a specific number of bytes from a large memory pool called the “heap.”
Однако этот запрос может завершиться неудачей. Если в системе закончилась доступная память, malloc() will return NULL (a special pointer to address zero) to signal failure. Robust code must always check for this possibility. Furthermore, once the program is finished with that memory, it must explicitly return it to the system using free(). Failing to do so creates a “memory leak,” where the program holds onto memory it no longer needs, potentially causing it to run out of resources and crash over time.
Связь с наукой о данных: Это напрямую применимо к работе с большими наборами данных. Попытка загрузить огромный CSV- или Parquet-файл в DataFrame Pandas может легко привести к сбою скрипта, если он запросит больше памяти, чем доступно системе. Принципы malloc и free are fundamental to writing scalable data pipelines, understanding why certain processes are “memory-bound,” and appreciating the design of modern data tools that use techniques like chunking or memory mapping to process data that won’t fit into memory all at once.
Вывод 5: Функции имеют приватные рабочие пространства (The Stack)
При вызове функции ей предоставляется собственное рабочее пространство в области памяти, называемой «стеком». Этот «фрейм стека» хранит её локальные переменные, включая переданные ей аргументы.
Лекция CS50 демонстрирует это на примере swap function intended to swap two integer values. The initial version fails because it only swaps копии значения внутри собственного закрытого кадра стека. Это называется «передача по значению». После завершения функции её кадр стека исчезает, и исходные переменные в вызывающей функции (main) are left completely unchanged. The corrected version works by “pass by reference”—passing the memory адреса исходных переменных. Это дает swap function the power to reach back into the caller’s stack frame and modify the original variables directly.
Связь с наукой о данных: Эта концепция имеет решающее значение для понимания области видимости и изменяемости переменных при написании функций преобразования данных. Она помогает объяснить, почему функция может не изменять переданный ей DataFrame должным образом (например, если она переназначает переменную внутри себя вместо изменения объекта на месте). Она также подчеркивает принципы проектирования «чистых функций» — функций, которые не изменяют свои входные данные, — которые необходимы для создания воспроизводимых, тестируемых и безошибочных аналитических конвейеров.
Вывод 6: Ошибка на миллиард долларов — это погрешность в одну единицу.
«Переполнение буфера» происходит, когда программа пытается записать данные за пределы выделенных границ буфера памяти, например, массива. Это как попытка налить галлон воды в стакан объемом в пинту — излишки должны куда-то деться, и часто они перезаписывают соседние области памяти, вызывая повреждение данных и сбои.
В лекции приводится пример реального инцидента с программным обеспечением безопасности CrowdStrike. Ошибка в обновлении привела к сбоям в работе систем по всему миру. Причина оказалась удивительно простой: код ожидал массив из 20 значений, а получил 21. Попытка доступа к несуществующему 21-му элементу привела к ошибке «чтение за пределы допустимого диапазона памяти», что вызвало сбой системы. В языке C нет автоматической защиты от подобных ошибок, что делает этот пример наглядным примером опасного класса уязвимостей.
Связь с наукой о данных: это важнейший урок по защитному программированию при работе с данными. При анализе файлов, итерации по спискам или обработке ответов API нельзя быть уверенным, что входящие данные соответствуют вашим ожиданиям. Эта уязвимость низкого уровня подчеркивает важность надежной обработки ошибок и проверки входных данных. Всегда добавляйте явные проверки ожидаемых форматов, размеров и границ перед обработкой данных, чтобы предотвратить сбой всего конвейера из-за одного неожиданного значения.
Что применить сегодня: Практический контрольный список
- Проанализируйте свои проверки на равенство: При сравнении сложных объектов, таких как модели или DataFrame, сделайте паузу и подтвердите, нужно ли вам знать, являются ли они одинаковыми. точно такой же объект в памяти (идентичности) или если они просто содержат одинаковые данные (равенство). Используйте соответствующий метод (
isпротив..equals()) for your goal. - Проведите аудит изменений в вашем DataFrame: Прежде чем изменять то, что вы считаете копией DataFrame, явно проверьте, является ли это представлением или копией. Простое изменение представления может незаметно повредить исходный набор данных. Используйте
.copy()to ensure you have an independent object. - Проявляйте инициативу в отношении памяти: При работе с большими файлами не стоит просто загружать их и надеяться на лучшее. Используйте инструменты для проверки доступной системной памяти и обрабатывайте файлы небольшими порциями (например, с помощью...).
chunksizeвpandas.read_csv) to avoid requesting more memory than is available. - Проверка границ данных: При обращении к данным по индексу, например, в списке или массиве, рассматривайте его как потенциальную точку отказа. Добавьте проверки, чтобы убедиться, что индекс находится в пределах ожидаемого диапазона, особенно если размер данных определяется внешним источником.
- Никогда не доверяйте входным данным: Данные из файлов, API или пользовательского ввода следует рассматривать как принципиально ненадежные. Перед выполнением операций добавьте утверждения или явные проверки типов, размеров и форматов данных, чтобы выявить неожиданные проблемы до того, как они исказят ваш анализ.
9. Заключительные мысли
Эти низкоуровневые концепции работы с памятью — не просто академические факты; они напрямую проявляются в виде ошибок, узких мест в производительности и угроз безопасности, с которыми мы сталкиваемся в высокоуровневой работе с данными. Понимая, что происходит в памяти, мы можем перейти от путаницы, вызванной симптомами, к диагностике первопричины. По мере прохождения курса CS50 эти же принципы становятся строительными блоками для создания эффективных структур данных, которые лежат в основе наших баз данных и алгоритмов.
Какую недавнюю «странную» ошибку в вашем коде теперь можно объяснить одним из этих основных принципов работы с памятью?