


Руководство для специалистов по анализу данных по курсу CS50x: основные выводы из базового курса информатики Гарвардского университета
Введение: Почему основы информатики важны для работы с данными
Для тех из нас, кто работает в области анализ данных, науки о данных и статистики, путь к профессионализму часто пролегает через курсы по моделированию, визуализации и специализированным инструментам. Однако за высокоуровневыми библиотеками и фреймворками, которые мы используем ежедневно, скрывается фундаментальная основа информатики. Понимание этих основных принципов — как данные хранятся в памяти, почему одна структура данных работает быстрее другой и как данные перемещаются с бэкэнд-сервера в браузер пользователя — это не просто академическое упражнение. Это практическое преимущество, позволяющее нам писать более эффективный код, создавать более надежные конвейеры обработки данных и разрабатывать более сложные продукты на основе данных.
Данное руководство представляет собой синтез базового курса по информатике Гарвардского университета CS50x 2025, основанный на общедоступных лекциях на YouTube. Его цель — выделить наиболее актуальные концепции и навыки из курса и представить их аудитории действующих и будущих специалистов по работе с данными.
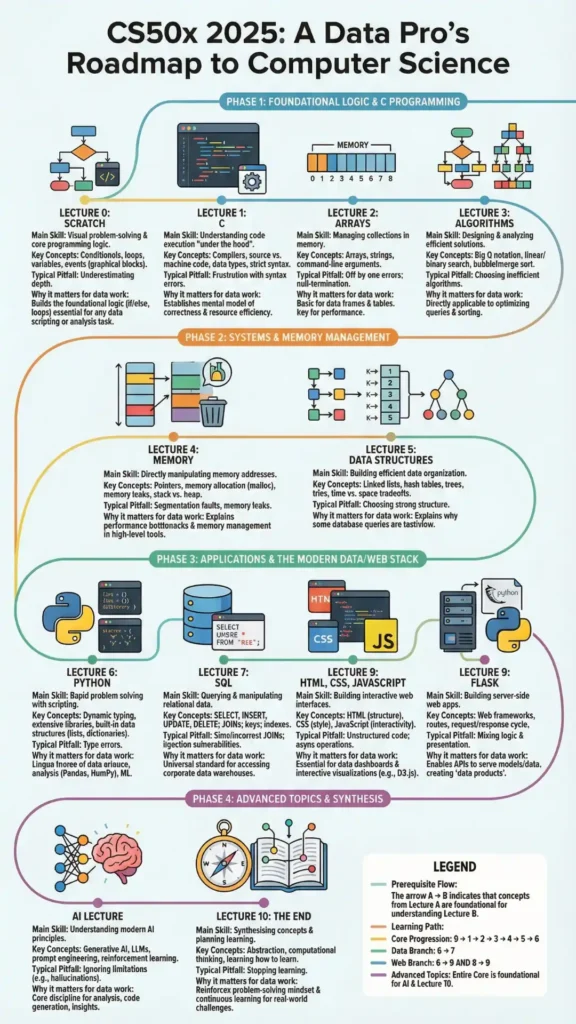
1. Путь к CS50x: трехэтапный обзор для специалистов по работе с данными.
Учебную программу CS50x можно рассматривать как трехэтапный процесс, начиная с основ низкого уровня и заканчивая высокоуровневыми абстракциями и, наконец, разработкой полнофункциональных приложений. На каждом этапе формируются навыки, непосредственно применимые к ролям, ориентированным на работу с данными.
1.1. Этап 1: Основы языка C (лекции 0-5)
Курс начинается не с традиционного языка программирования, а с визуальной среды программирования Scratch, после чего быстро переходит к языку C. Этот начальный этап посвящен основным концепциям программирования, ручному управлению памятью (лекция 4) и фундаментальным структурам данных, таким как хеш-таблицы, деревья и префиксные деревья (лекция 5). Для специалиста по работе с данными работа на низкоуровневом языке, таком как C, формирует важнейшее «механическое понимание» — интуитивное знание того, как данные хранятся, обрабатываются и манипулируются на фундаментальном уровне. Эти знания бесценны для диагностики узких мест производительности и написания оптимизированного кода, даже на высокоуровневых языках, таких как Питон.
1.2. Этап 2: Абстракция и современные инструменты (лекции 6 и 6.5)
Этот этап знаменует собой решающий переход к Python, который в курсе представлен как высокоуровневый язык с «готовыми к использованию» функциями. Лекция 6 наглядно иллюстрирует этот сдвиг, переписывая сложные программы на C, такие как проверка орфографии и фильтры изображений, всего несколькими строками кода на Python, используя его богатую экосистему библиотек. Это напрямую отражает зависимость специалистов по анализу данных от экосистемы Python (Pandas, NumPy, Scikit-learn). Затем курс углубляется в искусственный интеллект (лекция 6.5), охватывая широкий спектр тем, от фундаментальных концепций, таких как деревья решений и обучение с подкреплением, до современных приложений, таких как большие языковые модели (LLM) и разработка подсказок.
1.3. Этап 3: Данные и веб-технологии (лекции 7-9)
Заключительный этап курса посвящен интеграции этих навыков для создания полноценных приложений, управляемых данными. В этом разделе рассматриваются вопросы управления и хранения данных — например, в CSV-файлах, используемых в примерах лекций, — и использования фреймворка Flask для создания динамических веб-приложений, которые могут взаимодействовать с этими данными (лекция 9). Этот этап служит завершающим этапом, обучая специалистов по работе с данными тому, как выйти за рамки автономных скриптов и анализов. Он предоставляет навыки создания интерфейсов, где данные могут храниться, извлекаться и представляться конечным пользователям через пользовательский веб-интерфейс, превращая анализ или модель в пригодный для использования продукт на основе данных.
2. 10 важнейших выводов для специалистов по работе с данными
- Основы языка C начального уровня формируют установку на достижение высоких результатов: Ручное управление памятью в C, тема, противопоставленная автоматическому управлению памятью в Python в лекции 6, заставляет понимать вычислительные затраты. Это формирует интуитивное понимание производительности, которое помогает специалистам по работе с данными писать более эффективный код на Python и понимать, почему одни операции обходятся дороже других.
- Структуры данных — это практические инструменты, а не только теория: Как обсуждалось в лекции 5, понимание «преимуществ и недостатков» таких структур, как хеш-таблицы, напрямую применимо к работе с данными. Эти теоретические знания помогают принимать практические решения, например, при выборе языка программирования Python.
setилиdictfor O(1) average-time complexity lookups during feature engineering, which is vastly more performant than an O(n) search through a list when deduplicating millions of records. - Настоящая сила Python заключается в его экосистеме библиотек: В лекции 6 демонстрируется реализация фильтров изображений и проверки орфографии за гораздо меньшее время и с меньшим объемом кода, чем требуется в C. Это подчеркивает, как обширная экосистема библиотек Python — та же самая экосистема, которая включает Pandas, NumPy и Matplotlib — является истинным двигателем производительности в области анализа данных.
- Learning Как Умение учиться — это важнейший навык: Одна из заявленных целей лекции 6 — научить студентов «самостоятельно осваивать новый язык», начав с C и перейдя на Python. Для специалистов по работе с данными в быстро развивающейся области этот мета-навык крайне важен для того, чтобы оставаться в курсе новых инструментов, фреймворков и технологий.
- Внедрите в конвейеры обработки ошибок подход, характерный для Python: В этом курсе сравнивается использование в языке C специальных возвращаемых значений для сигнализации об ошибках с более выразительным подходом Python.
try...exceptblocks (Lecture 6). This exception-handling model is far superior for building robust and debuggable data pipelines that can gracefully handle unexpected issues without failing silently. - API — это шлюз к современным приложениям для работы с данными: В лекции 6.5 представлен чат-бот с искусственным интеллектом, работающий в режиме реального времени и использующий API OpenAI, что демонстрирует важнейший современный навык. Умение работать с API необходимо для доступа к сторонним наборам данных, использования облачных моделей машинного обучения и интеграции аналитических данных в более крупные программные приложения.
- Логика на стороне сервера — это способ перехода от анализа к применению: Примеры Flask из лекции 9 показывают, как бэкэнд-фреймворк выступает в качестве моста между источником данных (например, CSV-файлом или базой данных) и пользователем. Это ключевой навык, позволяющий специалистам по работе с данными создавать интерактивные панели мониторинга, интерфейсы для моделей машинного обучения и другие продукты на основе данных, выходящие за рамки статических отчетов.
- Серверная проверка данных обеспечивает их целостность: В лекции 9 подчеркивается, что проверка на стороне клиента — это удобство для пользователя, а не мера безопасности, и ее легко обойти. Применение правил и проверок качества данных на сервере является фундаментальным принципом поддержания целостности и надежности любого набора данных. Это первая линия защиты качества данных, предотвращающая загрязнение обучающих данных некорректными или недействительными записями или нарушение работы последующей модели.
- Использование шаблонов позволяет отделить анализ от презентации: В этом курсе демонстрируется, как шаблонизатор Jinja в Flask использует простую логику, например:
{% for sport in sports %}to dynamically generate HTML (Lecture 9). This principle of separating logic from presentation is directly applicable to creating scalable data reports and dashboards, where the visual layer automatically adapts to changes in the underlying data. - Понимание основ искусственного интеллекта развеивает мифы: Лекция 6.5 знакомит с основными принципами таких концепций, как деревья решений, обучение с подкреплением и нейронные сети. Эти фундаментальные знания формируют ментальную модель того, как на самом деле работают современные инструменты ИИ, включая LLM, позволяя специалисту по обработке данных использовать их более эффективно, критически и с учетом их ограничений.
3. Рекомендуемые направления обучения
3.1. Трек 1: Для начинающих (Новичкам в программировании)
Целевая аудитория: Люди с минимальным или полным отсутствием опыта программирования, желающие получить прочную и всестороннюю базу знаний.
Рекомендация:
- Пройдите курс последовательно, начиная с лекции 0 и заканчивая лекцией 9.
- Не пропускайте лекции по языку C; строгий, низкоуровневый подход к мышлению бесценен для формирования глубокого понимания принципов работы компьютеров.
- Обратите особое внимание на переход от C к Python в лекции 6, поскольку он наглядно демонстрирует компромиссы и преимущества языков высокого уровня.
3.2. Трек 2: Средний уровень (знает язык, только начинает изучать информатику)
Целевая аудитория: Специалисты (например, аналитики, знакомые со скриптами Python/R), не имеющие формального образования в области информатики.
Рекомендация:
- Уделите особое внимание лекциям 4 (Память) и 5 (Структуры данных). Это основная теория информатики, которая дает наибольшие преимущества для написания высокопроизводительного и масштабируемого кода.
- Рассматривайте лекцию 6 (Python) как повторение пройденного материала, но обратите особое внимание на сравнения с языком C, чтобы понять компромиссы в проектировании языков программирования.
- Внимательно изучите лекцию 9 (Flask), чтобы понять, как структурировать полнофункциональное приложение — навык, который помогает перейти от написания отдельных скриптов к созданию продуктов на основе данных.
3.3. Трек 3: Повторение материала для специалистов по анализу данных
Целевая аудитория: Опытные специалисты по анализу данных, стремящиеся укрепить базовые знания и освоить современные инструменты.
Рекомендация:
- Повторите материал лекции 5 (Структуры данных), чтобы освежить знания о характеристиках производительности различных способов организации данных.
- Углубленно изучите лекцию 6.5 (Искусственный интеллект), чтобы получить четкое, базовое понимание технологий, лежащих в основе LLM-моделей и генеративных инструментов, широко распространенных в отрасли.
- Внимательно изучите лекцию 9 (Flask) как практическое руководство по развертыванию моделей и созданию интерактивных приложений для работы с данными — ключевой навык на «последнем этапе» для обеспечения ценности.
Заключение: От кода к мастерству
В конечном итоге, такой курс, как CS50x, предлагает нечто большее, чем просто обзор языков программирования и концепций. Для специалиста по работе с данными он предоставляет интеллектуальный инструментарий, позволяющий перейти от использования инструментов к созданию решений. Принципы управления памятью, структур данных и архитектуры полного стека — это не академические препятствия; это прямые рычаги для создания более эффективных, надежных и ценных продуктов на основе данных. Инвестируя в эти основы, вы переходите от простого анализа данных к созданию приложений, основанных на данных, с уверенностью и профессионализмом.


