
Уроки информатики о том, как на самом деле работает искусственный интеллект.
Для аналитиков данных и специалистов по обработке информации этот разбор лекции по информатике из Гарварда превращает теорию информатики в практическую мудрость для повседневной работы.
Введение: Скрытая цена принципа «Это просто работает»
Вам когда-нибудь приходилось сталкиваться с трудностями при отладке странных результатов работы модели или объяснять заинтересованной стороне «черный ящик» прогноза? В науке о данных мы часто используем мощные инструменты, которые, кажется, «просто работают» — до тех пор, пока не перестают работать. Разочарование от неожиданных результатов часто возникает из-за разрыва между использованием инструмента и пониманием его основополагающих принципов. Рассматривая современные проблемы обработки данных через призму фундаментальной информатики, мы можем перейти от простого использования инструментов к уверенному и ясному управлению ими. Этот пост представляет собой синтез лекции по искусственному интеллекту CS50x 2025 (Гарвард), доступной на YouTube. В нем изложены пять конкретных выводов, которые связывают теорию информатики с практическими реалиями работы с данными, предоставляя вам высокоэффективные концепции, которые вы можете применить немедленно.
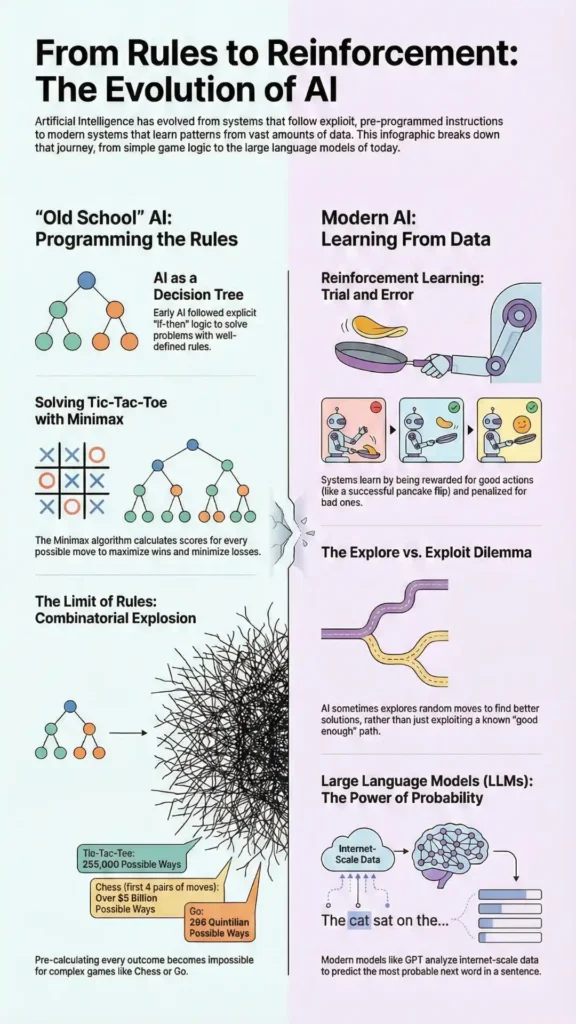
Главный вывод 1: Искусственный интеллект — это спектр от простых правил до сложных вероятностей.
Искусственный интеллект — это не монолит, а спектр. На одном конце находятся простые, детерминированные системы. В лекции в качестве классического примера используется игра в крестики-нолики. «Искусственный интеллект» для этой игры можно построить, используя... Древо решений—серия if-else rules—and an algorithm called МинимаксАлгоритм присваивает оценка состояниям доски (например, +1 за победу, -1 за поражение, 0 за ничью) и, двигаясь в обратном направлении, выбирает ход, который приводит к наилучшему возможному результату. Такой подход является исчерпывающим и гарантирует победу или ничью. Однако эта основанная на правилах логика осуществима только в условиях жестких ограничений. Как отмечается в лекции, в более сложной игре, такой как шахматы, существует более 85 миллиардов способов сыграть только первые четыре пары ходов, что делает построение полного дерева решений вычислительно невозможным.
На другом конце спектра находятся современные вероятностные системы, такие как модели больших языков (LLM). Эти модели не следуют явным правилам. Вместо этого, как объясняется в лекции, они работают, предсказывая наиболее вероятное следующее слово в последовательности на основе обширных закономерностей и частот, которые они изучили на основе обучающих данных. Они работают с вероятностями, а не с достоверностью.
Связь с наукой о данных: Этот спектр напрямую соответствует распространенным подходам в области анализа данных. Например, написание явных бизнес-правил в SQL, таких как: CASE WHEN ... THEN, is like building a decision tree. In contrast, training a statistical model that assigns probabilities to different outcomes is working on the other end of the spectrum. Understanding where your specific business problem falls on this continuum—from needing deterministic rules to benefiting from probabilistic inference—is crucial for choosing the right tool for the job.
Вывод 2: «Оперативное проектирование» — это всего лишь структурированный контекст.
Расхожий термин «разработка подсказок» (prompt engineering) меньше связан с эзотерическими командами и больше с предоставлением структурированного контекста. В лекции это объясняется на примере ИИ-помощника «резиновая уточка» с CS50. Подсказка состоит из двух ключевых частей: системной подсказки и пользовательской подсказки. Пользовательская подсказка — это просто вопрос, который задает человек. Системная подсказка, написанная разработчиком, представляет собой набор инструкций, которые указывают ИИ, как себя вести и каким ограничениям следовать.
Команда CS50 задала своей утке очень специфическую системную подсказку, чтобы изменить ее поведение с обычного LLM на полезного, но не обманщика, помощника преподавателя. Инструкции включали прямые команды, такие как:
«Вы дружелюбный и отзывчивый ассистент преподавателя по курсу CS50».
«Ты тоже резиновая уточка».
«Не давайте полных ответов на поставленные задачи, так как это будет нарушением академической честности».
Эти инструкции обеспечивают необходимый контекст для того, чтобы ИИ мог сгенерировать полезный, специфичный для данной области и безопасный ответ, а не просто ответ по умолчанию.
Связь с наукой о данных: Это напрямую аналогично определению объема и ограничений для любого проекта анализа данных. Хорошая «системная подсказка» для анализа дается не искусственному интеллекту, а вам и вашим заинтересованным сторонам. Она может включать определение ключевых бизнес-терминов («Что именно представляет собой «активный пользователь»?»), указание диапазона дат или формулировку основного бизнес-вопроса, на который вы пытаетесь ответить. Такая первоначальная формулировка предотвращает напрасные усилия, неправильное толкование и гарантирует, что окончательный анализ будет релевантным и правильным.
Вывод 3: Критический компромисс: разведка против эксплуатации
Одна из важнейших концепций в области ИИ — это дилемма между исследованием и использованием. В лекции это иллюстрируется простой игрой в лабиринт, где агент ИИ должен найти зеленый выход, избегая лавовых ям. Первоначально агент находит a путь случайно и, благодаря подкреплению, учится следовать ему многократно. Это и есть использование— применение известной информации для достижения надежного результата.
Однако первый путь может оказаться не самым лучший . Чтобы найти более оптимальный, короткий маршрут, ИИ необходимо внести небольшую долю случайности, определяемую в лекции как «значение эпсилон», которое представляет собой заданную вероятность (например, 5% или 10%) того, что агент совершит случайный ход вместо выбранного им наилучшего хода. Это стимулирует исследование— попытку новых, случайных ходов, даже если это означает риск кратковременной неудачи, например, падения в лавовую яму. Со временем эта небольшая возможность исследования позволяет ИИ открывать более эффективные стратегии.
Этот принцип был наглядно продемонстрирован на примере обучения ИИ игре Breakout. Используя лишь элементарные уловки, ИИ просто двигал ракетку взад и вперед. Но, исследуя возможности, он обнаружил нетривиальную, но весьма эффективную стратегию — проталкивание мяча вдоль одной стороны ракетки, что позволило игре, по сути, «пройтись самой по себе» и набрать огромное количество очков.
Связь с наукой о данных: Этот компромисс является центральным элементом работы в области науки о данных. A/B-тестирование — это формальная версия этого подхода: вы продолжаете использовать проверенный вариант (эксплуатация), тестируя при этом новый вариант, чтобы определить, лучше ли он (исследование). Это применимо и к оптимизации моделей, где вы можете попробовать новые гиперпараметры вместо того, чтобы оставаться с теми, которые уже достаточно хорошо работают. Это даже применимо к развитию карьеры: будете ли вы использовать уже знакомые инструменты (эксплуатация) или потратите время на изучение нового языка или фреймворка, который может оказаться более мощным (исследование)?
Вывод 4: Магистранты — это специалисты по сопоставлению образов, а не абстрактные мыслители.
Согласно лекции, большие языковые модели не занимаются рассуждениями или «мышлением» в человеческом понимании. Это невероятно сложные системы сопоставления образов. Построенные на нейронных сетях, большие языковые модели предварительно обучаются на огромных массивах текста из интернета. Их основная функция заключается в вычислении наиболее вероятного следующего слова в последовательности, учитывая слова, которые были перед ним.
В лекции это объясняется просто: «…если кто-то спросит меня, как дела, то, основываясь на всех этих данных, я уверен, что в 99% случаев, когда я общаюсь с PT или cs50's duck, он ответит: «Хорошо, спасибо, как дела?»». Модель чувствует себя неважно; она просто генерирует статистически наиболее вероятный ответ на основе своих обучающих данных.
Вероятностная природа является непосредственной причиной галлюцинаций. Когда модель LLM уверенно утверждает что-то, что фактически неверно, это происходит потому, что закономерности в ее обучающих данных указывают на то, что неверное утверждение представляет собой правдоподобно звучащую последовательность слов. Она составляет статистически вероятное предложение, а не проверяет факт.
Связь с наукой о данных: это имеет серьезные последствия для специалистов по работе с данными. Результаты LLM никогда не следует рассматривать как истину в последней инстанции. Вместо этого их следует рассматривать как хорошо сформулированные гипотезы, требующие проверки по первоисточникам. Такой критический подход необходим для поддержания аналитической строгости. Использование результатов LLM без проверки может привести к распространению дезинформации в ваших отчетах, панелях мониторинга и моделях, подрывая доверие к вашей работе.
Вывод 5: Настоящее решение на основе ИИ — это система, а не просто модель.
Полезный инструмент ИИ редко представляет собой просто отдельную модель. Это целая система, построенная вокруг этой модели. В лекции представлена «архитектурная схема» отладчика CS50 duck debugger, которая прекрасно иллюстрирует этот момент. Команда CS50 не создавала свою собственную модель LLM с нуля. Вместо этого они создали ценный инструмент, интегрировав несколько ключевых компонентов.
Система включает в себя удобный интерфейс для студентов, локальную базу данных Vector , используемую для хранения и поиска расшифрованных лекций, а также подключения к используется для хранения и поиска транскрибированного содержания лекций и связей с третьими сторонами API сторонних поставщиков, таких как OpenAI. Главное достижение команды заключалось не в создании новой базовой модели, а в объединении этих элементов в систему, эффективно решающую конкретную образовательную задачу.
Связь с наукой о данных: Это важнейший урок для специалистов по данным, требующий изменения мышления от «я создаю модели» к «я проектирую решения, основанные на данных». Реальная ценность для бизнеса редко заключается в отдельной модели, какой бы сложной она ни была. Она заключается в системе: в конвейерах данных, которые питают модель, в API, которые предоставляют ее прогнозы, и в интерфейсах, которые делают ее пригодной для использования. Мышление как у архитектора означает, что ваш фокус расширяется от оптимизации алгоритма к проектированию целостной системы, решающей задачи.
Что подать заявку сегодня
- Составьте «Системное подсказку» для вашего следующего проекта: Прежде чем писать код, составьте абзац, определяющий ваши цели, ограничения и ключевые параметры, подобно подсказке в задании CS50.
- Разграничьте понятия «исследование» и «эксплуатация»: В вашей текущей работе найдите одну область, где вы «используете» известный процесс. Задайте себе вопрос, как мог бы выглядеть небольшой «исследовательский» эксперимент.
- Сопоставьте проблему с деревом решений: Решение простой бизнес-задачи с помощью доски.
if-then-elselogic of a decision tree. Does this clarify the logic? - Проверяйте, не доверяйте: Воспринимайте следующую информацию, полученную от генеративного ИИ, как гипотезу. Потратьте три минуты на попытку проверить её, используя первоисточник.
- Мыслите системно: При построении модели нарисуйте простую схему необходимых ей входных данных и выходных результатов. Как человек или другая система будут её использовать?
Заключение: От кода к познанию
Понимание фундаментальных принципов информатики, лежащих в основе ИИ, не просто развеивает мифы о технологии; оно дает вам основу для управления, ясности и критического мышления. Такие понятия, как деревья решений, вероятностное рассуждение и компромисс между исследованием и использованием данных, — это не абстрактные теории, а практические инструменты для создания более надежных и эффективных решений для работы с данными. Эти идеи составляют основу, на которой можно строить более глубокое понимание еще более сложных тем. По мере того, как эти вероятностные системы все больше интегрируются в наши инструменты, как нам нужно будет адаптировать наши собственные методы для обеспечения аналитической достоверности?