


Почему ваши цифры могут быть неверными: основные выводы CS50 для специалистов по работе с данными
В этой статье фундаментальные концепции информатики объясняются аналитикам и специалистам по обработке данных, показывая, как более глубокое понимание вычислительной техники может предотвратить распространенные ошибки, исправить проблемы с производительностью и повысить надежность вашей работы.
Введение: Насекомые, прячущиеся на виду у всех
Вы наверняка сталкивались с подобной ситуацией: конвейер обработки данных необъяснимо дает сбой, скрипт работает на порядки медленнее, чем ожидалось, или SQL-запрос возвращает число, которое кажется неправильным. Вы можете винить в этом высокоуровневые инструменты или сложность самих данных. Однако истинная причина часто кроется в фундаментальных принципах информатики, на которых построены ваши скрипты Питон и SQL-запросы. Игнорируя «низкоуровневые» детали работы компьютеров, вы допускаете в свой анализ скрытые, труднодиагностируемые ошибки.
Этот пост представляет собой обобщение материала лекции CS50x 2025 (Гарвард) на YouTube. В нем собраны несколько наиболее важных выводов из первой лекции по программированию на C, которые непосредственно применимы в повседневной работе любого специалиста по работе с данными, помогая создавать более надежные, производительные и корректные системы обработки данных.
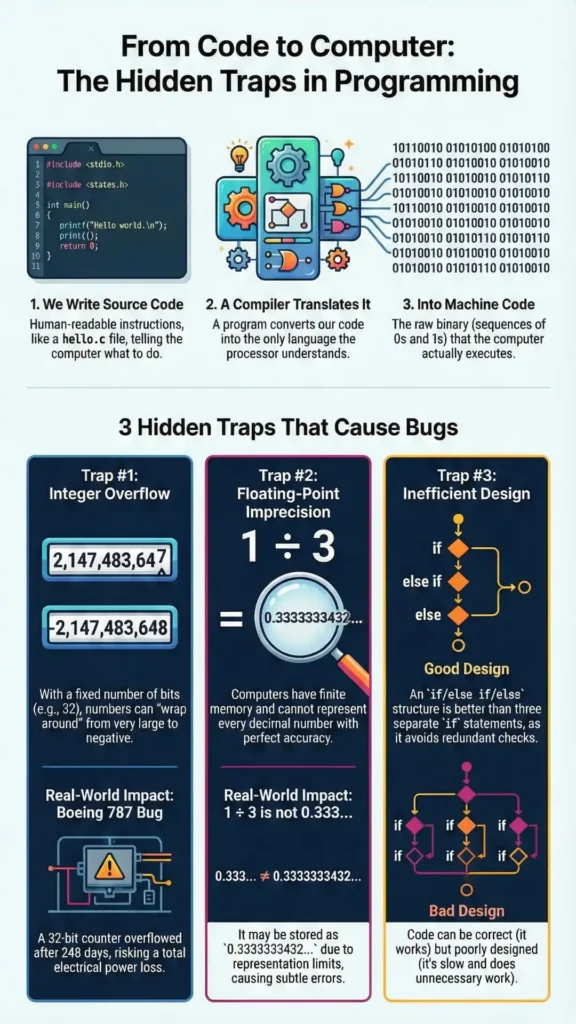
1. Исходный код против машинного кода: «Почему» важна производительность.
По своей сути, процессор компьютера понимает только один язык: машинный код, последовательность нулей и единиц. Код, который вы пишете, будь то Python, SQL или C, называется исходным кодом — набором инструкций, понятных человеку. Чтобы преодолеть этот разрыв, специальная программа, называемая компилятором, преобразует ваш исходный код в машинный код, который компьютер может фактически выполнить.
На лекции... make hello command is used to compile a C source code file (hello.c) into an executable program (hello) composed of machine code. This compilation step is the key to understanding performance differences between programming languages and tools.
Связь с наукой о данных: По моему опыту, это один из наиболее часто упускаемых из виду источников узких мест в производительности команд, работающих с данными. Интерпретируемые языки, такие как Python, часто скрывают этот этап компиляции, но многие высокопроизводительные библиотеки для анализа данных (например, NumPy или pandas) написаны на компилируемых языках, таких как C, не просто так. Представьте себе... for loop in pure Python to calculate a moving average over millions of rows—it could take minutes. The equivalent NumPy function, which calls pre-compiled C code, executes in milliseconds. That’s the performance gap we’re talking about. This is why you must understand this distinction to choose the right tools and avoid crippling bottlenecks in your data pipelines.
«Компьютеры, конечно, не понимают исходный код, они понимают только нули и единицы, так называемую двоичную систему. Поэтому нам нужно как-то превратить то, что уже выглядит загадочно, в нечто, что на первый взгляд кажется еще более загадочным — нули и единицы, которые понимают компьютеры». — Harvard CS50x 2025 (YouTube) — Лекция: C
2. Командная строка — это не архаизм, это сила.
Вероятно, вы взаимодействуете с компьютерами через графический пользовательский интерфейс (GUI) — мир значков, окон и щелчков мыши. Интерфейс командной строки (CLI), или терминал, может показаться «шагом назад» в чисто текстовую среду. Однако CLI предлагает уровень мощности, эффективности и автоматизации, недостижимый с помощью GUI, поэтому он остается предпочтительной средой для многих разработчиков.
В лекции представлены несколько основных команд, лежащих в основе навигации и работы с файловой системой: ls (list files), cd (change directory), mv (move or rename a file), and rm (remove a file).
Связь с наукой о данных: знание командной строки (CLI) является обязательным условием для серьезной работы с данными. Это основной способ взаимодействия с удаленными серверами, где хранятся ваши данные и модели. CLI необходим для автоматизации конвейеров обработки данных с помощью инструментов планирования (например, cron-заданий), управления облачными ресурсами на AWS или GCP, а также использования систем контроля версий, таких как Git, для обеспечения воспроизводимости вашей работы. Графический интерфейс пользователя (GUI) подходит для локального исследования, но автоматизация и воспроизводимость достигаются с помощью командной строки.
3. Основы качества: корректность, дизайн и стиль.
Оценка кода — это не просто вопрос «работает» или «не работает». В лекции представлена простая, но эффективная трехэтапная модель оценки качества любой программы, которая одинаково хорошо применима как к скрипту анализ данных так и к приложению на языке C.
- Правильность: Выдает ли код желаемый результат? Если попросить его вычислить среднее значение, вернет ли он правильное число? Это базовый показатель для любого функционального кода.
- дизайн: Насколько хорошо написан код? Эффективен ли он и логичен? В лекции приводится пример плохого проектирования: явная проверка.
if x == yafter you have already checked forx < yиx > y. Logically, equality is the only remaining possibility, so the final check is redundant. - Стиль: Является ли код читаемым и эстетически приятным для других людей? Это включает в себя такие вещи, как единообразные отступы, понятные имена переменных и логичные пробелы, которые не влияют на работу компьютера, но оказывают огромное влияние на удобство сопровождения кода.
Связь с наукой о данных: Этот фреймворк я использую при каждом обзоре кода для конвейера обработки данных. Конвейер может быть исправить (Он формирует правильный отчет), но плохо. предназначенныйПлохо спроектированный конвейер обработки данных может повторно считывать 10-гигабайтный CSV-файл с диска внутри цикла для трех разных этапов обработки, вместо того чтобы считывать его в память один раз. Оба варианта «правильны», но один из них на порядки медленнее и дороже. Аналогично, плохой конвейер обработки данных стиль В контексте данных это не просто неаккуратный отступ; это SQL-запрос на 500 строк без комментариев и именованных CTE. temp1, temp2, and crucial business logic buried in a subquery six levels deep. It’s unmaintainable.
4. Не повторяйтесь: абстракция через функции и библиотеки.
Ключевой принцип эффективного программирования — абстракция: решение задачи один раз, а затем упаковка этого решения для повторного использования. Это позволяет избежать повторений и упрощает чтение и сопровождение кода. В лекции рассматриваются две основные формы абстракции.
Первый использует библиотекиВключая такую фразу, как #include <stdio.h> или #include <cs50.h> grants a programmer access to a library of pre-written, pre-tested code. This means they can use powerful functions like printf (to print to the screen) without having to write the complex underlying code from scratch themselves.
Второй способ – это создание пользовательские функцииВ простом, но наглядном примере лекция создает meow function to contain the logic of printing “meow” to the screen. By calling meow() three times instead of printf("meow") three times, the main part of the program becomes cleaner and more clearly expresses its intent.
Связь с наукой о данных: Этот принцип лежит в основе всей современной экосистемы анализа данных. Мы не пишем собственный код для создания фреймов данных или выполнения регрессионного анализа с нуля; мы используем такие библиотеки, как pandas, NumPy и scikit-learn. В меньшем масштабе вам необходимо применять тот же подход к своей работе. Если вы постоянно используете регулярные выражения для извлечения идентификатора продукта из неструктурированного текстового поля, инкапсулируйте эту логику в def extract_product_id(text): function. Your main analysis script becomes cleaner, and that function can now be reused across multiple projects.
5. Ошибка на миллиард долларов: переполнение целых чисел.
В лекции приводится наглядная демонстрация: программа начинает с числа 1 и неоднократно спрашивает пользователя, хочет ли он «удвоить его и отдать следующему человеку». Число экспоненциально возрастает до миллиардов, затем внезапно становится большим отрицательный числом и, наконец, падает до нуля. Это не логическая ошибка в коде; это фундаментальное ограничение компьютера.
Это явление называется переполнением целых чисел. Компьютеры хранят целые числа, используя фиксированное количество битов (например, 32 бита). 32-битное целое число может представлять только числа до примерно 2 миллиардов. Когда вы пытаетесь добавить 1 к этому максимальному значению, места больше нет. Биты «зацикливаются», и огромное положительное число превращается в огромное отрицательное число, вызывая катастрофическую, незаметную ошибку.
Это не просто теоретическая проблема. В лекции упоминается реальная проблема с самолетом Boeing 787, где программный счетчик, отслеживающий время, переполнялся после 248 дней непрерывной работы, что потенциально могло привести к полному отключению электропитания самолета.
Связь с наукой о данных: Классическая и дорогостоящая ошибка, которую я часто вижу у начинающих аналитиков, — это игнорирование риска переполнения целочисленных типов данных. Именно поэтому необходимо тщательно выбирать подходящие типы данных. Администраторы баз данных очень внимательно относятся к этому вопросу. BIGINT instead of INT for primary keys (like user IDs) that could one day exceed 2 billion. Imagine summing a transaction column that overflows; your final financial report would be dramatically, silently incorrect. Always be aware of the limits of the data types you’re using.
6. Ложь, которую рассказывает ваш компьютер: неточность вычислений с плавающей запятой.
Подобно тому, как целые числа имеют конечное число битов, так и числа с плавающей запятой (числа с десятичной точкой, хранящиеся в виде float или double). This leads to another subtle but critical issue: неточность чисел с плавающей запятой.
В лекции приводится наглядный пример: когда программа делит 1 на 3, результатом не является бесконечная последовательность чисел. 0.333333.... Instead, it might be something like 0.3333333432... after a certain number of decimal places. The root cause is the same: with a finite number of bits, a computer cannot represent all possible real numbers with perfect accuracy. It stores a very close approximation, but the tiny difference can have major consequences.
Связь с наукой о данных: Игнорирование этого приведет к скрытым, раздражающим ошибкам в вашем анализе. Простая проверка, например, такая: if column_a == 0.3 might unexpectedly fail because the value is actually stored as 0.29999999999999998. These tiny errors can accumulate during complex calculations, potentially affecting statistical tests, model coefficients, or any task that relies on high numerical accuracy. The best practice is a hard rule: “никогда не научится делать” Для проверки точного равенства используйте числа с плавающей запятой; вместо этого проверьте, находятся ли они в пределах небольшого отклонения друг от друга.
Что нужно подать сегодня: контрольный список из 5 пунктов
- Просмотрите типы данных. в ключевой таблице базы данных. Это
INTsufficient for a primary key that could grow beyond 2 billion? Consider upgrading toBIGINT. - Напишите одну пользовательскую функцию В следующем скрипте анализа используйте его для выполнения повторяющихся задач по очистке или преобразованию данных вместо копирования и вставки кода.
- Используйте форматтер кода (например, Black for Python или онлайн-форматтер SQL) для автоматического улучшения стиля и читаемости вашего следующего скрипта.
- Открыть терминал и потратьте пять минут на навигацию по структуре файлов вашего проекта, используя только
ls(list) andcd(change directory). - При следующем обзоре кода, задать вопрос о дизайнеРечь идёт не только о корректности. Например: «Этот запрос работает, но можно ли упростить эту логику, чтобы сделать её более эффективной?»
Заключительные мысли
Хотя такие понятия, как выделение памяти и машинный код, могут показаться далекими от построения модели классификации, они являются основой, на которой строятся все надежные и отказоустойчивые системы обработки данных. Игнорирование их означает работу вслепую с целым классом потенциальных ошибок и проблем с производительностью. Курс CS50 продолжает развивать эти низкоуровневые идеи, переходя к языкам программирования более высокого уровня и более сложным задачам. Осознание этих основ — первый шаг к написанию кода, которому вы действительно можете доверять.
Какая из этих «незаметных» деталей вычислительной техники, скорее всего, повлияла на один из ваших прошлых анализов, даже без вашего ведома?



