Случайный лес на практике: основное руководство
Вы узнаете, как Random Forest использует деревья решений для повышения точности прогнозирования в сложных наборах данных.
Введение
Случайный Лес— это важный алгоритм машинного обучения, получивший широкую популярность в области науки о данных благодаря своей эффективности в задачах классификации и регрессии. В основе его успеха лежит способность строить множество деревьев решений в процессе обучения и выдавать моду классов (классификация) или среднее предсказание (регрессия) отдельных деревьев. Это вводное руководство призвано развеять мифы о случайном лесу для начинающих, предоставляя четкое пошаговое объяснение принципа его работы, а также практическое руководство по его реализации на Питон. Наша цель — дать читателям знания, необходимые для понимания теоретических основ случайного леса и эффективного применения его в своих проектах в области науки о данных, используя мощные возможности программирования Python.
Основные моменты:
- Случайный лес превосходит одиночные деревья решений за счет уменьшения переобучения.
- Настройка гиперпараметров в Random Forest существенно повышает точность модели.
- Предварительная обработка данных имеет решающее значение для успеха прогнозирования Random Forest.
- Пошаговое руководство по Python упрощает реализацию случайного леса.
- Оценка моделей случайного леса включает в себя метрики точности, точности и полноты.
Заголовок объявления
Описание объявления. Lorem ipsum dolor sit amet, consectetur adipiscing elit.
Понимание случайного леса
Случайный Лес— это алгоритм машинного обучения, основанный на концепции деревьев решений, который обеспечивает более точную и надежную прогностическую модель. В процессе обучения он создает множество деревьев решений. На выходе он выдает класс, то есть моду классов (в классификации) или среднее предсказание (в регрессии) отдельных деревьев.
Как работает случайный лес:
Деревья решений: Алгоритм случайного леса начинается с деревьев решений, которые представляют собой простые древовидные модели принятия решений. Каждое дерево в случайном лесу выдает предсказание, и алгоритм принимает в качестве окончательного результата голос большинства или среднее значение в случае регрессии.
Метод бутстреппинга: Этот метод случайным образом выбирает подмножество набора данных для каждого дерева, обеспечивая разнообразие среди деревьев и способствуя устойчивости модели.
Агрегация (бэггинг): Затем алгоритм агрегирует прогнозы отдельных деревьев, чтобы получить более точный и стабильный прогноз.
Преимущества случайного леса:
Снижение риска переобучения: В отличие от отдельных деревьев решений, которые часто страдают от переобучения на обучающих данных, алгоритм случайного леса снижает этот риск благодаря ансамблевому подходу. Усреднение прогнозов от множества деревьев гарантирует, что общий прогноз модели не будет чрезмерно зависеть от какой-либо одной части обучающих данных, что приводит к более обобщаемым результатам.
Высокая точность: Сила алгоритма Random Forest заключается в объединении прогнозов от нескольких деревьев решений, каждое из которых обучено на разных подмножествах одних и тех же данных. Этот ансамблевый метод значительно повышает точность прогнозирования, превосходя многие подходы, основанные на одной модели, на различных наборах данных и типах задач.
Универсальность в применении: структура алгоритма Random Forest позволяет ему превосходно справляться с различными задачами, от прогнозирования категориальных результатов в задачах классификации до оценки непрерывных переменных в регрессионном анализе. Надежная обработка наборов данных с пропущенными значениями и способность обрабатывать числовые и категориальные данные без сложной предварительной обработки делают его исключительно гибким.
Анализ важности признаков: Одна из выдающихся возможностей алгоритма случайного леса — это встроенный механизм отбора признаков. Анализируя влияние каждого признака на точность прогнозирования во всех деревьях, алгоритм случайного леса может ранжировать важность признаков в наборе данных. Это понимание бесценно для осмысления факторов, влияющих на прогнозы. Оно может помочь в отборе признаков при уточнении модели и анализ данных процессы.
Применение случайного леса:
Финансы: Алгоритм Random Forest широко используется в финансовом секторе для решения важных задач, таких как оценка кредитного риска путем анализа кредитных рейтингов и прогнозирование будущих движений на фондовом рынке, а также для разработки инвестиционных стратегий.
Электронная коммерция: Этот алгоритм улучшает опыт онлайн-покупок, обеспечивая работу рекомендательных систем, которые предлагают товары на основе поведения и предпочтений пользователя. Он также играет ключевую роль в сегментации клиентов на различные группы для целевых маркетинговых и рекламных стратегий.
Здравоохранение: В медицинской сфере алгоритм Random Forest способствует ранней диагностике заболеваний, анализируя данные пациентов на предмет симптомов, указывающих на конкретные состояния. Он также помогает классифицировать пациентов по группам риска, что облегчает разработку персонализированных планов лечения.
Кибербезопасность: Учитывая растущую изощренность киберугроз, алгоритм Random Forest помогает своевременно обнаруживать и прогнозировать потенциальные случаи мошенничества и нарушения безопасности, используя обнаружение аномалий в массивах данных для защиты цифровых активов.
Теоретические основы случайного леса
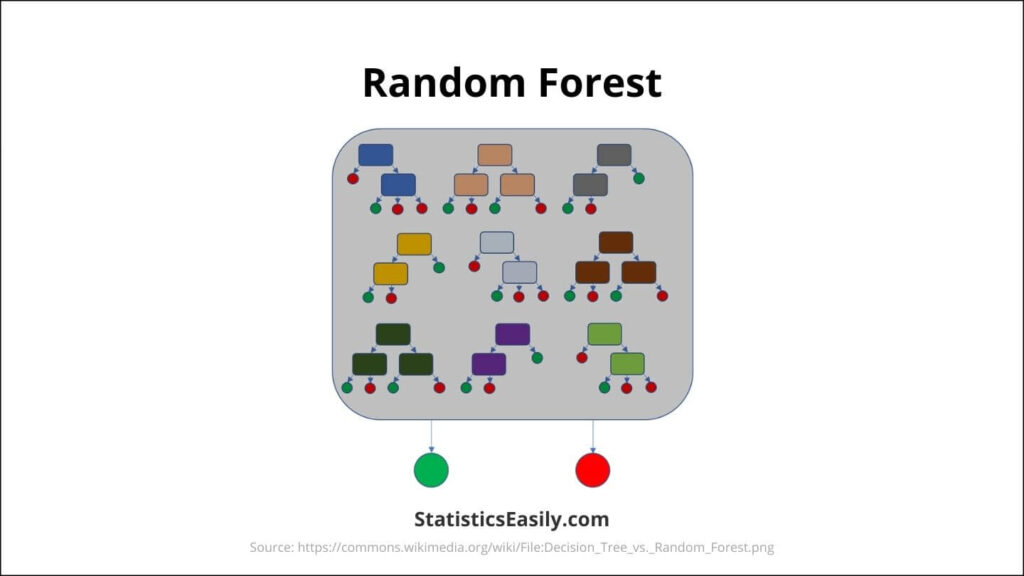
Случайный Лесработает по принципу ансамблевого обучения, где несколько классификаторов, в данном случае деревья решений, объединяются для решения сложной задачи и повышения производительности модели.
Подробное объяснение алгоритма:
Ансамбль деревьев решений: алгоритм случайного леса создает лес некоррелированных деревьев решений, каждое из которых обучается на случайных подмножествах обучающих данных с использованием метода бутстреппинга.
Случайный выбор признаков: Каждое дерево выбирает случайное подмножество признаков при каждом разбиении. Эта случайность помогает сделать деревья более разнообразными, повышая общую точность модели.
Агрегация: Окончательный прогноз алгоритма Random Forest определяется путем агрегирования прогнозов отдельных деревьев. Эта агрегация уменьшает дисперсию, контролирует переобучение и повышает точность прогнозирования модели.
Гиперпараметры и их влияние:
Количество деревьев (n_estimators): Увеличение количества деревьев, как правило, улучшает производительность модели, но увеличивает вычислительные затраты.
Максимальная глубина (max_depth): управляет глубиной каждого дерева. Более глубокие деревья могут улавливать более сложные закономерности, но могут привести к переобучению.
Минимальное количество выборок для разделения (min_samples_split): определяет минимальное количество выборок, необходимых для разделения внутреннего узла. Более высокие значения предотвращают обучение модели слишком специфическим закономерностям.
Максимальное количество признаков (max_features): Размер случайных подмножеств признаков, которые следует учитывать при разделении узла. Он влияет на разнообразие деревьев в лесу.
Измерение эффективности:
Точность подачи: Доля правильно предсказанных наблюдений от общего числа наблюдений. Это важный показатель для задач сбалансированной классификации.
Матрица ошибок: Подробный анализ производительности модели, включая истинно положительные, истинно отрицательные, ложноположительные и ложноотрицательные результаты.
Точность, полнота и F1-мера: Точность — это отношение правильно предсказанных положительных наблюдений к общему числу предсказанных положительных наблюдений. Полнота (чувствительность) измеряет отношение правильно предсказанных положительных наблюдений ко всем наблюдениям в фактическом классе. F1-мера — это взвешенное среднее точности и полноты. Эти метрики критически важны в контексте несбалансированных наборов данных.
Подготовка ваших данных
Эффективная предварительная обработка данных — важнейший шаг в машинном обучении, который существенно влияет на производительность таких моделей, как Random Forest. В этом разделе описаны основные этапы очистки и подготовки данных, обеспечивающие оптимальную структуру данных для моделирования случайных лесов.
Важность предварительной обработки данных:
Предварительная обработка данных преобразует необработанные данные в чистый набор данных, который можно использовать непосредственно в моделях машинного обучения. Этот процесс жизненно важен, поскольку он напрямую влияет на способность модели обучаться и делать точные прогнозы. Для случайного леса, где задействовано несколько деревьев решений, предварительная обработка обеспечивает согласованность и качество всего набора данных, позволяя алгоритму более эффективно выявлять закономерности.
Шаги по очистке и подготовке данных:
1. Обработка пропущенных значений: Алгоритм случайного леса может в некоторой степени обрабатывать пропущенные значения. Однако, как правило, лучшей практикой является заполнение пропущенных значений с использованием таких стратегий, как заполнение средним значением для числовых признаков и заполнение модой для категориальных признаков.
2. Кодирование категориальных переменных: Преобразуйте категориальные переменные в числовой формат с помощью методов кодирования, таких как one-hot кодирование или кодирование меток, поскольку алгоритм Random Forest не может обрабатывать необработанные текстовые данные.
3. Масштабирование признаков: Хотя алгоритм случайного леса не так чувствителен к масштабированию признаков, как алгоритмы SVM или KNN, обеспечение одинакового масштаба всех признаков может помочь улучшить сходимость модели и интерпретируемость оценок важности признаков.
4. Удаление нерелевантных признаков: Исключите признаки, которые не влияют на прогнозирование или могут вносить шум. Хотя алгоритм случайного леса выбирает признаки случайным образом во время обучения, предварительное уменьшение размерности может сократить время и сложность обучения.
Разделение набора данных:
Обучающий и тестовый наборы данных: Разделите ваши данные на обучающий и тестовый наборы, чтобы оценить производительность модели на неизвестных данных. Типичное соотношение разделения составляет 70:30 или 80:20, где большая часть используется для обучения.
Перекрестная проверка: Рекомендуется использовать методы перекрестной проверки, особенно k-кратную перекрестную проверку, чтобы обеспечить согласованность производительности модели на разных подмножествах данных.
Практическое применение случайного леса на Python
Применение алгоритма Random Forest вПитонэффективно сочетает теоретическое понимание алгоритма с практическими навыками программирования. В этом разделе вы узнаете, как настроить среду Python, реализовать алгоритм Random Forest с помощью библиотекиsklearnи применить его к реальному набору данных.
Практический пример: предсказание видов ирисов
Набор данных Iris содержит 150 растений ирисов, разделенных на три вида на основе четырех признаков: длина чашелистика, ширина чашелистика, длина лепестка и ширина лепестка. Модель «Случайный лес» обучается на основе обучающих данных и точно предсказывает виды ирисов.
Следуя приведенным ниже шагам, вы можете реализовать случайные леса в Python для различных наборов данных, а не только для набора данных Iris. Настройте гиперпараметры модели, такие как n_estimators и max_eep, чтобы повысить производительность в зависимости от вашего конкретного набора данных и задачи.
Предоставленные фрагменты кода просты в использовании и снабжены пояснениями для каждого шага, облегчающими понимание и реализацию. Это практическое применение демонстрирует возможности случайных лесов в прогнозном моделировании. Он обеспечивает прочную основу для изучения более сложных проектов в области науки о данных.
Настройка среды Python
Чтобы работать со случайным лесом в Python, убедитесь, что на вашем компьютере установлен Python. Используйте следующие пакеты:
- NumPy: Для работы с массивами и матрицами.
- Панды: Для манипулирования и анализа данных.
- Scikit-learn (склеарн): предоставляет алгоритм случайного леса и дополнительные функции для построения прогнозных моделей.
- Матплотлиб/Сиборн: Для визуализации данных и результатов модели.
Установите эти пакеты с помощью pip:
pip install numpy pandas scikit-learn matplotlib seaborn
Реализация случайного леса с помощью sklearn
Модуль sklearn.ensemble включает RandomForestClassifier для задач классификации и RandomForestRegressor для задач регрессии. Вот пошаговое руководство по использованию RandomForestClassifier:
1. Импортируйте необходимые библиотеки:
from sklearn.ensemble import RandomForestClassifier
from sklearn.model_selection import train_test_split
from sklearn.metrics import accuracy_score, confusion_matrix, classification_report
import pandas as pd
import matplotlib.pyplot as plt
import seaborn as sns
2. Загрузите свой набор данных:Для этого примера мы будем использовать набор данных Iris, классический пример из области машинного обучения.
from sklearn.datasets import load_iris
iris = load_iris()
X = iris.data
y = iris.target
3. Разделите набор данных:разделите ваши данные на обучающую и тестовую выборки, чтобы оценить производительность модели.
X_train, X_test, y_train, y_test = train_test_split(X, y, test_size=0.3, random_state=42)
4. Инициализация и обучение модели:Создайте экземпляр RandomForestClassifier и обучите его на ваших обучающих данных.
clf = RandomForestClassifier(n_estimators=100, random_state=42)
clf.fit(X_train, y_train)
5. Сделайте прогнозы и оцените модель:используйте обученную модель для прогнозирования на тестовом наборе данных и оцените точность.
y_pred = clf.predict(X_test)
print(f"Accuracy: {accuracy_score(y_test, y_pred)}")
Результаты модели и интерпретация
После обучения модели и составления прогнозов крайне важно интерпретировать результаты, чтобы понять ее производительность и способы ее улучшения.
Оценка производительности модели:Сначала изучите точность модели, затем проанализируйте более подробные метрики.
# Model Accuracy
print(f"Model Accuracy: {accuracy_score(y_test, y_pred):.2f}")
Матрица ошибок:Матрица ошибок позволяет понять, какие прогнозы были правильными, а какие — неправильными для каждого класса.
cm = confusion_matrix(y_test, y_pred)
sns.heatmap(cm, annot=True, fmt="d", cmap="viridis", xticklabels=iris.target_names, yticklabels=iris.target_names)
plt.xlabel('Predicted')
plt.ylabel('Actual')
plt.title('Confusion Matrix')
plt.show()
Отчет о классификации:Отчет о классификации включает такие метрики, как точность, полнота и F1-мера для каждого класса.
print(classification_report(y_test, y_pred, target_names=iris.target_names))
Важность признаков:Понимание того, какие признаки оказывают наиболее существенное влияние на решения вашей модели, может дать ценные сведения о наборе данных.
feature_importance = clf.feature_importances_
sns.barplot(x=feature_importance, y=iris.feature_names)
plt.title('Feature Importance')
plt.show()
Интерпретация модели
Показатель точности, матрица ошибок и отчет о классификации в совокупности дают полное представление о производительности модели. Высокая точность указывает на эффективность модели в классификации видов ирисов, а матрица путаницы и отчет о классификации детализируют ее точность, полноту и f1-показатели по классам.
График важности признаков показывает, какие характеристики цветов ириса (например, длина или ширина лепестков) влияют на решения по классификации модели. Это понимание ценно для понимания процесса принятия решений в модели случайного леса и будущих усилий по проектированию или выбору функций.
Интерпретируя эти результаты, мы можем сделать вывод, что классификатор «Случайный лес» очень эффективен для этого набора данных, обеспечивая прочную основу для задач прогнозного моделирования. Экспериментирование с различными наборами данных или корректировка гиперпараметров может повысить производительность модели или ее адаптируемость к различным проблемам.
Интерпретация отдельных деревьев решений в случайном лесу
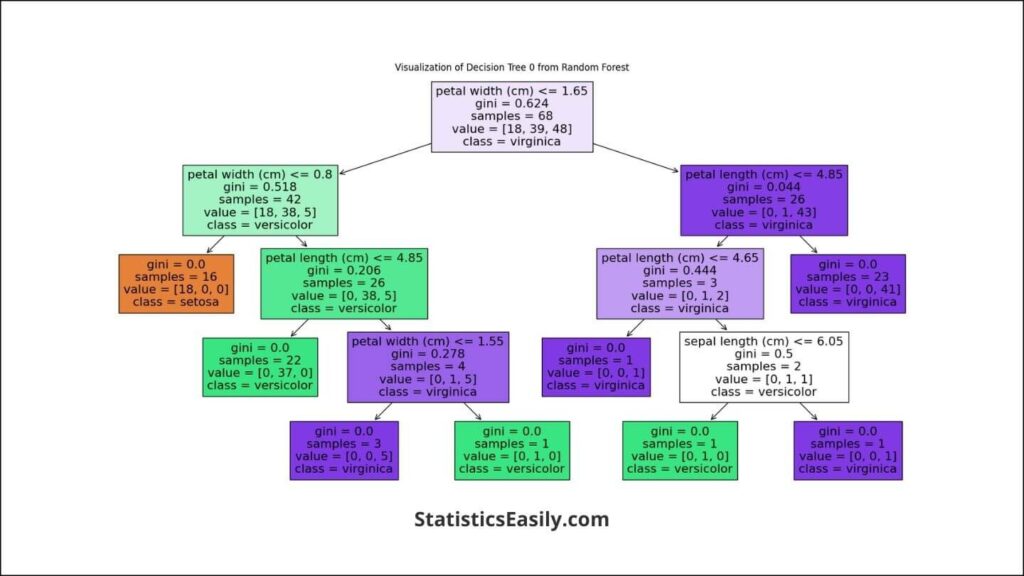
Хотя случайный лес представляет собой набор деревьев решений, каждое дерево вносит свой вклад в результат. Визуализация отдельных деревьев может дать представление о процессе принятия решений на более детальном уровне. Давайте рассмотрим одно такое дерево из нашей модели случайного леса:
Визуализация дерева решений из случайного леса:
# Visualize the first decision tree from the Random Forest
tree_index = 0
plt.figure(figsize=(20,10))
plot_tree(clf.estimators_[tree_index],
          feature_names=iris.feature_names,
          class_names=iris.target_names,
          filled=True,
          rounded=True)
plt.title(f'Decision Tree Visualization: Tree {tree_index}')
plt.show()
Эта визуализация демонстрирует, как одно дерево решений в случайном лесу выполняет классификации. Он начинается сверху с корневого узла, затем разделяется на ветви и узлы принятия решений на основе значений признаков и, наконец, заканчивается листовыми узлами, представляющими прогнозы классов.
Анализ древовидной структуры:
Каждый узел в дереве представляет собой решение, основанное на значении определенного признака. Например, узел может разделить данные на основе длины или ширины лепестка ириса. Ветви представляют собой результат этого решения, приводящий к новым узлам принятия решений или листовым узлам. Листовые узлы предоставляют окончательные прогнозы класса, когда выполняется набор критериев, определяемых путем от корня.
Глубина и сложность этого дерева указывают на стратегию классификации модели. На практике случайный лес объединяет прогнозы нескольких таких деревьев для создания окончательной, более точной классификации, тем самым используя сильные стороны каждого дерева и компенсируя их недостатки.
Включение визуализации дерева решений, такой как созданная выше, может обогатить вашу статью, позволяя читателям визуализировать процесс прогнозирования. Он проясняет работу модели и представляет собой наглядный пример того, как случайный лес использует несколько путей принятия решений для принятия решения о классификации.
Оценка вашей модели
После реализации модели случайного леса с использованием Python следующим важным шагом является оценка ее производительности. Это предполагает использование конкретных показателей, чтобы понять, насколько хорошо модель прогнозирует результаты на новых, ранее неизвестных данных. В этом разделе рассматриваются критически важные показатели оценки и предлагаются советы по улучшению и настройке модели.
Как оценить производительность вашей модели случайного леса:
Метрики оценки необходимы для оценки точности и эффективности вашей модели случайного леса. Вот наиболее часто используемые показатели:
Точность подачи: это наиболее простой показатель, рассчитываемый как количество правильных предсказаний, деленное на общее количество предсказаний. Хотя точность сама по себе полезна, она может вводить в заблуждение, особенно в наборах данных с несбалансированными классами.
Точность и полнота: Точность (доля истинно положительных результатов среди всех положительных прогнозов) и полнота (доля истинно положительных результатов среди всех фактически положительных результатов) имеют решающее значение, когда затраты на ложноположительные и ложноотрицательные результаты высоки, например, в сценариях медицинской диагностики или выявления мошенничества.
F1 Score: F1-мера — это гармоническое среднее точности и полноты, представляющее собой единый показатель для оценки их сбалансированности. Наилучшее значение F1-меры равно 1 (идеальная точность и полнота), а худшее — 0.
Матрица ошибок: таблица, используемая для описания эффективности модели классификации на наборе тестовых данных, для которых известны истинные значения. Она позволяет визуализировать прогнозы модели, включая истинно положительные, ложноположительные, истинно отрицательные и ложноотрицательные результаты.
Интерпретация результатов:
Понимание этих показателей позволяет точно оценить производительность модели. Например, высокая точность на первый взгляд может показаться превосходной. Однако дальнейшая проверка точности, полноты и оценки F1 может выявить области, в которых модель испытывает трудности, например, неспособность точно предсказать конкретный класс.
Советы по улучшению и настройке модели:
Настройка гиперпараметра: Модели случайного леса имеют несколько гиперпараметров, таких как количество деревьев (n_estimators) и глубина деревьев (max_depth), которые могут существенно влиять на производительность. Использование методов перебора по сетке или случайного поиска может помочь найти оптимальную комбинацию этих гиперпараметров для вашего конкретного набора данных.
Выбор признаков: Случайные леса по своей природе способны ранжировать важность признаков. Анализируя и исключая менее важные признаки, можно уменьшить сложность модели и повысить её производительность.
Перекрестная проверка: Использование перекрестной проверки, например, k-кратной перекрестной проверки, помогает обеспечить согласованность производительности вашей модели на разных подмножествах набора данных, тем самым повышая ее надежность.
Заголовок объявления
Описание объявления. Lorem ipsum dolor sit amet, consectetur adipiscing elit.
Заключение
В этой статье представлено подробное руководство по пониманию и применению случайного леса в Python, охватывающее его теоретические основы, подготовку данных, практическую реализацию и оценку модели. Благодаря своей способности эффективно решать задачи классификации и регрессии, Random Forest остается мощным инструментом в арсенале специалистов по обработке данных, предлагая высокую точность и устойчивость к переобучению. Поощрение экспериментировать с различными наборами данных и решать различные проблемы прогнозного моделирования подчеркивает универсальность и адаптируемость Random Forest. Следуя подробным инструкциям, от настройки среды Python до оценки производительности модели, читатели будут хорошо подготовлены к использованию Random Forest в своих проектах по науке о данных, расширяя границы прогнозного анализа.
Рекомендуемые статьи
Дополнительные сведения и учебные пособия по темам Data Science можно найти в других наших статьях.
- Деревья решений: от теории к практике на Python для начинающих специалистов по данным
- Понимание случайной выборки: основные методы анализа данных
- Случайная выборка в Excel: углубленный анализ
- Логистическая регрессия с использованием Scikit-Learn (История)
- Сгенерировать случайное число
Часто задаваемые вопросы (FAQ):
В1: Что такое случайный лес?Это универсальный метод машинного обучения, способный выполнять задачи регрессии и классификации, используя несколько деревьев решений и усредняя их прогнозы для повышения точности и контроля переобучения.
В2: Как работает случайный лес?Случайный лес создает «лес» из случайных деревьев решений, чтобы сделать свои прогнозы более точными, чем любое отдельное дерево решений, за счет усреднения результатов или использования голосования по большинству.
В3: Почему алгоритм Random Forest предпочтительнее других алгоритмов?Он предпочтительнее благодаря своей универсальности, способности обрабатывать большие наборы данных с высокой размерностью и возможности управлять пропущенными значениями, что делает его устойчивым к переобучению.
В4: Каковы основные области применения алгоритма Random Forest?Он широко используется в различных областях, таких как банковское дело, медицина, фондовый рынок и электронная коммерция, для обнаружения мошенничества, прогнозирования заболеваний, прогнозирования цен на акции и сегментации клиентов.
В5: Как подготовить данные для алгоритма «Случайный лес»?Подготовка данных включает в себя очистку, обработку пропущенных значений, кодирование категориальных переменных и разделение набора данных на обучающую и тестовую выборки.
В6: Что такое гиперпараметры в алгоритме случайного леса и как они влияют на модель?Гиперпараметры влияют на сложность и производительность модели, например, количество деревьев, глубина деревьев и минимальное количество разбиений выборки. Настройка этих параметров может значительно повысить точность.
В7: Как оценить эффективность модели случайного леса?Стандартные метрики оценки включают точность, прецизионность, полноту, F1-меру и матрицу ошибок, которые помогают оценить прогностическую эффективность и точность модели.
В8: С какими трудностями можно столкнуться при использовании случайных лесов?Несмотря на свою мощь, случайные леса могут быть вычислительно затратными и сложными для интерпретации по сравнению с более простыми моделями, а их производительность может быть чувствительна к зашумленным данным.
В9: Как настроить модель случайного леса для повышения производительности?Настройка модели включает в себя корректировку гиперпараметров, таких как количество деревьев, максимальная глубина и минимальное количество разбиений выборки, с помощью методов поиска по сетке или случайного поиска для нахождения наиболее оптимальных настроек.
В10: Может ли алгоритм Random Forest обрабатывать как категориальные, так и числовые данные?Да, алгоритм Random Forest может обрабатывать смешанные категориальные и числовые данные. Он использует такие методы, как one-hot кодирование для категориальных переменных, чтобы сделать данные пригодными для моделирования.