Линейная регрессия с Scikit-Learn: подробное руководство
С помощью scikit-learn вы изучите искусство и науку прогнозного моделирования с помощью линейной регрессии.
Введение
Линейная регрессия — это основополагающий метод в науке о данных, позволяющий прогнозировать и интерпретировать взаимосвязи между переменными. По своей сути линейная регрессия моделирует взаимосвязь между зависимой переменной и одной или несколькими независимыми переменными, используя линейное уравнение для прогнозирования результата. Эта простота и интерпретируемость делают линейную регрессию жизненно важным инструментом для аналитиков данных и ученых различных дисциплин.
Цель данной статьи — предоставить исчерпывающее руководство по реализациилинейная регрессия с scikit-learn, популярной библиотеки Питон для машинного обучения. Scikit-learn предлагает широкий спектр инструментов и алгоритмов для анализ данных и моделирования, что делает её идеальным выбором как для начинающих, так и для опытных специалистов в этой области.
В этом руководстве мы углубимся в теоретические основы и практические применения линейной регрессии. Начиная с основ, мы рассмотрим предположения и математические методы, лежащие в основе моделей линейной регрессии. После этого мы перейдем к практическим примерам с использованием scikit-learn для подготовки данных, построения моделей линейной регрессии и интерпретации их результатов. Чтобы проиллюстрировать эти концепции, мы можем использовать ранее созданный набор данных, демонстрирующий процесс анализа линейной регрессии от предварительной обработки данных до оценки модели.
Сочетая теоретические знания с практическими навыками, это руководство призвано дать читателям глубокое понимание линейной регрессии в контексте научного обучения, подготавливая их к применению этих концепций к реальным задачам науки о данных.
Основные моменты:
- Линейная регрессия с помощью scikit-learn позволяет прогнозировать результаты с поразительной точностью.
- API Scikit-learn упрощает сложный статистический анализ до понятных шагов.
- Предварительная обработка данных в scikit-learn повышает надежность и целостность модели.
- Передовые методы scikit-learn адресуют переоснащение, повышая точность модели.
- Реальные применения линейной регрессии с использованием scikit-learning позволяют принимать эффективные решения.
Заголовок объявления
Описание объявления. Lorem ipsum dolor sit amet, consectetur adipiscing elit.
Понимание линейной регрессии
Линейная регрессия — это ключевой статистический метод, который выявляет основную взаимосвязь между двумя или более переменными. Подбор линейного уравнения к наблюдаемым данным позволяет нам понять и предсказать поведение одной переменной на основе знания другой. Этот метод прогнозного моделирования предназначен не только для поиска линии, которая лучше всего соответствует данным, но и для раскрытия истины, скрытой в данных, что позволяет принимать обоснованные решения.
По своей сути линейная регрессия действует при ряде допущений, обеспечивающих ее практическое применение:
линейность: Зависимость между независимой и зависимой переменными является линейной. Это основополагающее предположение означает, что изменение независимой переменной приведет к пропорциональному изменению зависимой переменной.
Независимость: Наблюдения независимы друг от друга. Результат каждой точки данных не зависит от результатов других точек данных.
Гомоскедастичность: Дисперсия ошибок (остатков) остается постоянной на всех уровнях независимых переменных. Гомоскедастичность гарантирует, что точность прогнозирования модели будет равномерной по всему диапазону независимой переменной.
Нормальное распределение ошибок: ошибки зависимой переменной распределены нормально для любого фиксированного значения независимой переменной. Это предположение позволяет нам делать выводы и проверять гипотезы относительно коэффициентов, представляющих независимые переменные.
Понимание этих предположений имеет решающее значение для адекватного применения линейной регрессии, поскольку нарушения этих предположений могут привести к неточным моделям и вводящим в заблуждение результатам. Убедившись, что данные соответствуют этим предварительным условиям, специалисты-практики могут максимально использовать потенциал линейной регрессии, что делает ее мощным инструментом для интерпретации сложных наборов данных.
Использование scikit-learn для линейной регрессии включает подготовку данных в соответствии с этими предположениями с последующей подгонкой модели, ее оценкой и интерпретацией. Благодаря этому процессу линейная регрессия с scikit-learn становится не просто математической формулой, а мостом между данными и решениями, теорией и применением, ведущим нас к более обоснованным и точным прогнозам.
Введение в Scikit-Learn
Scikit-learn является образцом для всего сообщества специалистов по обработке данных, свидетельством духа сотрудничества и принципов открытого исходного кода, которые стимулируют инновации в этой области. Как библиотека, scikit-learn предлагает полный набор инструментов машинного обучения, от предварительной обработки данных и выбора модели до оценки и настройки. Принципы её проектирования отдают приоритет простоте использования, производительности и универсальности, что делает её доступной для новичков, но при этом достаточно мощной для опытных специалистов.
Приверженность библиотеки высококачественной документации и участию сообщества является еще одним примером передового опыта в разработке программного обеспечения для научных и образовательных целей. Scikit-learn — это набор алгоритмов и платформа для обучения, экспериментирования и открытий. Его архитектура поощряет лучшие практики моделирования данных, гарантируя, что пользователи могут получить доступ к самым современным методам машинного обучения и понять их принципы.
Используя scikit-learn для линейной регрессии и не только, специалисты по обработке данных могут уверенно и четко создавать прогностические модели. Реализация линейной регрессии в библиотеке, представленная классом'LinearRegression', обеспечивает мощный, но интуитивно понятный интерфейс для подгонки моделей к данным, анализа их производительности и построения прогнозов. Независимо от того, изучаете ли вы простые линейные зависимости или углубляетесь в более сложные многомерные наборы данных, scikit-learn служит надежным проводником в тонкостях машинного обучения, воплощая коллективную мудрость и усилия мирового сообщества специалистов по обработке данных.
Подготовка ваших данных
Прежде чем приступить к этапу моделирования с помощью scikit-learn, необходимо тщательно подготовить данные, чтобы обеспечить целостность и правдивость вашего анализа. Предварительная обработка данных — это важнейший этап в конвейере машинного обучения, включающий очистку, выбор функций и разделение данных на обучающие и тестовые наборы.
Выбор признаков: Начните с определения признаков, которые оказывают наиболее существенное влияние на вашу зависимую переменную. Не все точки данных одинаковы; некоторые могут оказывать незначительное или нулевое влияние на ваши результаты и могут вносить шум, если их включить в анализ.
Очистка данных: На этом этапе осуществляется обработка пропущенных значений, выбросов и, возможно, ошибочных данных, которые могут исказить результаты вашей модели. Варианты обработки пропущенных данных включают в себя импутацию, заполнение пропущенных значений на основе других точек данных, пропуск и удаление точек данных или признаков с пропущенными значениями.
Разделение данных: Разделение данных на обучающую и тестовую выборки имеет решающее значение. Эта практика позволяет обучить модель на одном подмножестве данных и проверить ее производительность на отдельном, ранее не встречавшемся подмножестве, обеспечивая непредвзятую оценку вашей модели.
Давайте рассмотрим наш ранее созданный набор данных для практического примера:
import pandas as pd
from sklearn.model_selection import train_test_split
from sklearn.linear_model import LinearRegression
from sklearn.metrics import mean_squared_error

# Load the dataset
data = pd.read_csv('/mnt/data/linear_regression_scikit_learn_dataset.csv')

# Feature selection
X = data[['TV', 'Radio']]  # Independent variables
y = data['Sales']  # Dependent variable

# Split the data into training and testing sets
X_train, X_test, y_train, y_test = train_test_split(X, y, test_size=0.2, random_state=42)

# Model initialization and training
model = LinearRegression()
model.fit(X_train, y_train)

# Model evaluation
y_pred = model.predict(X_test)
mse = mean_squared_error(y_test, y_pred)
print(f'Mean Squared Error: {mse}')
В этом примере мы подготовили данные, выбрав соответствующие признаки («рекламные бюджеты на ТВ»и«Радио») и целевую переменную («Продажи»). Затем мы разделили данные на обучающую и тестовую выборки, чтобы обеспечить объективную оценку нашей модели. Выполнение этих шагов гарантирует надежность, точность и соответствие модели реальным данным.
Реализация линейной регрессии с помощью Scikit-Learn
Реализация линейной регрессии с помощью scikit-learn проста и иллюстрирует простоту и мощь библиотеки. Ясность API scikit-learn делает даже сложный анализ доступным и понятным, позволяя ученым, работающим с данными, сосредоточиться на знаниях, а не на тонкостях алгоритмов.
Загрузите набор данных!
Шаг 1: Импорт библиотек и загрузка данных – Начните с импорта необходимых библиотек и загрузки вашего набора данных. Мы будем использовать набор данных, который мы подготовили ранее:
import pandas as pd
from sklearn.model_selection import train_test_split
from sklearn.linear_model import LinearRegression
from sklearn.metrics import mean_squared_error, r2_score

data = pd.read_csv('/mnt/data/linear_regression_scikit_learn_dataset.csv')
Шаг 2: Выбор признаков и целевой переменной – Определите независимые переменные (признаки) и зависимую переменную (целевую переменную). В нашем случае «ТВ» и «Радио» являются признаками, а «Продажи» – целевой переменной:
X = data[['TV', 'Radio']]  # Features
y = data['Sales']  # Target
Шаг 3: Разделите данные на обучающую и тестовую выборки . Для эффективной оценки производительности модели разделите данные на обучающую и тестовую выборки.
X_train, X_test, y_train, y_test = train_test_split(X, y, test_size=0.2, random_state=42)
Шаг 4: Инициализация и обучение модели линейной регрессии – Scikit-learn значительно упрощает инициализацию и обучение модели:
model = LinearRegression()
model.fit(X_train, y_train)
Шаг 5: Сделайте прогнозы и оцените модель . После обучения модели вы можете сделать прогнозы на тестовом наборе данных и оценить ее производительность:
y_pred = model.predict(X_test)
mse = mean_squared_error(y_test, y_pred)
r2 = r2_score(y_test, y_pred)

print(f"Mean Squared Error: {mse}")
print(f"R² Score: {r2}")
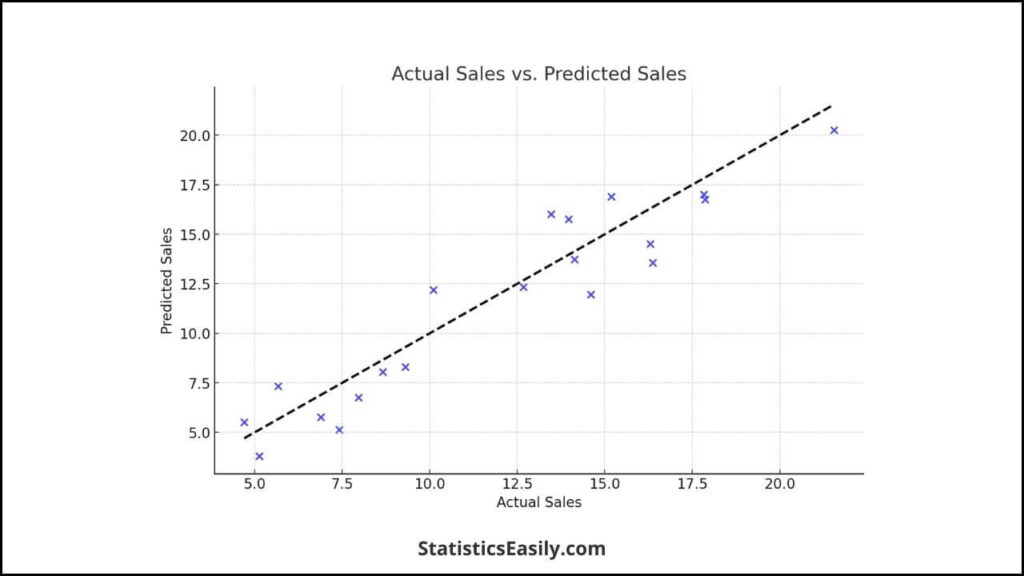
Визуализация производительности модели — визуальные представления могут дать интуитивно понятное представление о производительности модели. Например, построение графика фактических и прогнозируемых продаж:
import matplotlib.pyplot as plt

plt.scatter(y_test, y_pred)
plt.xlabel('Actual Sales')
plt.ylabel('Predicted Sales')
plt.title('Actual Sales vs. Predicted Sales')
plt.show()
Эта простая диаграмма рассеяния обеспечивает быструю визуальную оценку точности прогнозирования модели: точки, расположенные ближе к линии y = x, указывают на лучшую производительность.
Благодаря этим шагам scikit-learn демистифицирует процесс реализации линейной регрессии, делая его доступным как для новичков, так и для опытных практиков. Следуя этому руководству, вы сможете использовать возможности линейной регрессии для извлечения значимой информации из ваших данных, вооружившись ясностью и простотой API scikit-learn.
Интерпретация результатов
Интерпретация результатов регрессионной модели — важнейший шаг аналитического процесса, позволяющий понять взаимосвязь между переменными и предсказательную силу модели. В этом разделе мы интерпретируем модель линейной регрессии, созданную с помощью scikit-learn, уделяя особое внимание значимости коэффициентов, показателей модели и этическим соображениям при представлении результатов.
Интерпретация коэффициентов
Коэффициенты в модели линейной регрессии представляют собой изменение зависимой переменной при изменении независимой переменной на одну единицу, при этом все остальные переменные остаются постоянными. В нашей модели коэффициенты для рекламных бюджетов «ТВ» и «Радио» указывают на их соответствующее влияние на «Продажи». Положительный коэффициент предполагает прямую зависимость: увеличение рекламного бюджета приводит к увеличению продаж. Напротив, отрицательный коэффициент указывает на обратную зависимость.
Метрики модели
Двумя ключевыми показателями для оценки эффективности модели линейной регрессии являются среднеквадратическая ошибка (MSE) и значение R-квадрата (R²).
Среднеквадратичная ошибка (MSE)измеряет среднее значение квадратов ошибок, то есть среднюю квадратичную разницу между оценочными значениями и фактическими значениями. Более низкое значение MSE указывает на модель, которая точно соответствует данным.
Коэффициент детерминации R²представляет собой долю дисперсии зависимой переменной, которая может быть предсказана на основе независимых переменных, и варьируется от 0 до 1. Значение R², близкое к 1, указывает на модель, которая объясняет значительную часть дисперсии зависимой переменной.
Честная интерпретация и этические соображения
При интерпретации и представлении результатов регрессионного анализа первостепенное значение имеют честность и этические соображения. Очень важно признать ограничения модели, включая любые предположения, которые могут быть не совсем верными, или переменные, которые невозможно учесть. Завышение точности или предсказательной силы модели может привести к ошибочным решениям и неверным интерпретациям.
Прозрачность источников данных, этапов предварительной обработки и обоснования выбора конкретных переменных способствует доверию и достоверности результатов. Более того, каждый специалист по данным несет этическую ответственность за рассмотрение потенциального воздействия этих выводов на заинтересованные стороны и за обеспечение того, чтобы интерпретации не вводили в заблуждение и не причиняли вреда.
Интерпретация результатов модели линейной регрессии предполагает тщательное изучение коэффициентов и показателей модели, а также стремление к честности и этической добросовестности при представлении результатов. Такой подход обеспечивает надежность анализа и поддерживает принципы истины в науке о данных.
Линейная регрессия с расширенными темами Scikit-Learn
В целях совершенствования моделей линейной регрессии и повышения точности их прогнозирования появляется несколько передовых методов. Эти методы решают общие проблемы, такие как переобучение, и углубляют наше понимание линейного регрессионного анализа, демонстрируя его универсальность и глубину.
Регуляризация: ключ к уменьшению переобучения
Методы регуляризации, такие как Ridge (регуляризация L2) и Lasso (регуляризация L1), предотвращают переобучение. Эта распространенная ошибка возникает, когда модель хорошо работает на обучающих данных, но плохо на невидимых данных. Вводя штрафной член в функцию потерь, методы регуляризации ограничивают величину коэффициентов, тем самым предотвращая чрезмерное усложнение модели.
Гребневая регрессиядобавляет штраф, равный квадрату величины коэффициентов, фактически уменьшая их и снижая сложность модели.
С другой стороны, регрессия Lassoпозволяет обнулить некоторые коэффициенты, выполнить отбор признаков и предложить более интерпретируемую модель.
Реализация их в scikit-learn проста:
from sklearn.linear_model import Ridge, Lasso

# Ridge regression
ridge_model = Ridge(alpha=1.0)
ridge_model.fit(X_train, y_train)

# Lasso regression
lasso_model = Lasso(alpha=0.1)
lasso_model.fit(X_train, y_train)
The «альфа»регулирует силу регуляризации, при этом более высокие значения приводят к более существенным ограничениям на коэффициенты.
Методы оценки и проверки модели
Оценка и проверка эффективности моделей линейной регрессии имеют решающее значение для обеспечения их надежности и точности. Перекрестная проверка, надежный метод, включает в себя разделение набора данных на несколько подмножеств и обучение модели на некоторых подмножествах, одновременно проверяя ее на остальных. Этот подход обеспечивает более полную оценку эффективности модели в различных сегментах данных.
from sklearn.model_selection import cross_val_score

# Cross-validation with 5 folds
scores = cross_val_score(model, X, y, cv=5, scoring='neg_mean_squared_error')
The `cross_val_score`в библиотеке scikit-learn упрощает перекрестную проверку, при этом параметр`cv`задает количество фолдов. Выбор метрики оценки, такой как отрицательная среднеквадратичная ошибка, зависит от конкретных целей анализа.
Стремление к истине и точности в работе модели
Соблюдение принципов истинности и точности имеет первостепенное значение при развитии анализа линейной регрессии с помощью таких методов, как регуляризация и перекрестная проверка. Регуляризация обеспечивает достоверность модели, предотвращая ее подгонку шума. В то же время перекрестная проверка обеспечивает точность показателей производительности модели, предоставляя целостную оценку.
Этическое представление результатов данных, признающее ограничения и потенциальные искажения модели, усиливает целостность анализа. Эти передовые методы и этические соображения гарантируют, что линейный регрессионный анализ продолжает оставаться мощным инструментом в арсенале специалиста по данным, способным выявлять ценные сведения с точностью и надежностью.
Линейная регрессия с Scikit-Learn в реальных приложениях
Применение линейной регрессии в сфере научного обучения выходит далеко за рамки теоретических конструкций, глубоко внедряясь в структуру решения реальных проблем. В этом разделе освещается практическая полезность линейной регрессии в научном обучении посредством ярких иллюстраций ее применения в различных областях, подчеркивающих преобразующее влияние науки о данных на общество.
Прогнозирование цен на жилье:Одно из важнейших применений линейной регрессии — в сфере недвижимости, где она используется для прогнозирования цен на жилье на основе различных характеристик, таких как площадь, местоположение, количество спален и возраст объекта. Обучив модель линейной регрессии на исторических данных, аналитики рынка недвижимости могут оценить рыночную стоимость объектов, помогая покупателям и продавцам принимать обоснованные решения.
Прогнозирование продаж и выручки:Компании в различных секторах используют линейную регрессию для прогнозирования продаж и выручки, учитывая расходы на рекламу, сезонные тенденции и экономические показатели. Например, розничная компания может использовать линейную регрессию, чтобы понять влияние рекламной кампании на продажи, что позволит стратегически распределять маркетинговые бюджеты для достижения максимальной отдачи от инвестиций.
Здравоохранение: Прогнозирование прогрессирования заболевания:В здравоохранении модели линейной регрессии играют важную роль в прогнозировании прогрессирования заболевания на основе данных о пациенте, таких как возраст, вес, артериальное давление и уровень холестерина. Это применение не только помогает в ранней диагностике и разработке персонализированных планов лечения, но и в эффективном распределении ресурсов здравоохранения.
Анализ энергопотребления:Аналитики энергетического сектора используют линейную регрессию для прогнозирования структуры потребления на основе исторических данных, погодных условий и экономической активности. Такие прогнозные данные имеют решающее значение для компаний, занимающихся производством и распределением энергии, для эффективного управления спросом и предложением, способствуя внедрению устойчивых методов энергосбережения.
История успеха: Повышение урожайности сельскохозяйственных культур:Примечательной историей успеха является применение линейной регрессии в сельском хозяйстве для прогнозирования урожайности сельскохозяйственных культур. Анализируя такие переменные, как количество осадков, температура, качество почвы и сорт культуры, агрономы могут прогнозировать урожайность, тем самым оптимизируя сельскохозяйственные практики для повышения производительности. Это повышает продовольственную безопасность и поддерживает устойчивое сельское хозяйство за счет минимизации отходов и использования ресурсов.
Эти реальные приложения подчеркивают универсальность и практичность линейной регрессии с помощью scikit-learning для решения сложных задач в различных областях. Используя возможности данных, модели линейной регрессии проливают путь к проницательным решениям, стимулируя прогресс и оказывая положительное влияние на общество. Благодаря этим повествованиям мы являемся свидетелями воплощения принципов истины, добра и красоты в применении науки о данных, подтверждая глубокую роль линейной регрессии в формировании лучшего будущего.
Заголовок объявления
Описание объявления. Lorem ipsum dolor sit amet, consectetur adipiscing elit.
Заключение
В рамках изучениялинейная регрессия с scikit-learnмы совершили всестороннее путешествие по теоретическим основам и практическим применениям одной из самых фундаментальных методик в области науки о данных. Линейная регрессия — это маяк для прогнозирования и интерпретации сложного взаимодействия между зависимыми и независимыми переменными, её элегантность заключается в простоте и интерпретируемости.
В этом руководстве была предпринята попытка дать вам, читателю, четкое понимание линейной регрессии в рамках научного обучения, сочетая теоретические основы с практическими приложениями. От начальных шагов по изучению основных предположений, лежащих в основе моделей линейной регрессии, до практических упражнений по подготовке данных, построению моделей и интерпретации результатов, мы прошли путь, который сочетает теорию с практикой, понимание и применение.
Scikit-learn с его богатым хранилищем инструментов и алгоритмов оказался неоценимым союзником на этом пути. Его удобный API и обширная документация развеяли тайны сложного статистического анализа, сделав возможности линейной регрессии доступными для всех, кто стремится раскрыть закономерности, скрытые в их данных.
Описанные здесь реальные приложения — от прогнозирования цен на жилье до прогнозирования продаж, развития здравоохранения и оптимизации урожайности сельского хозяйства — подчеркивают повсеместное влияние линейной регрессии на принятие обоснованных решений в различных секторах. Эти повествования демонстрируют полезность линейной регрессии и прославляют преобразующую силу науки о данных в обществе.
Завершая это подробное руководство, пусть путешествие на этом не заканчивается. Область линейной регрессии, особенно в экосистеме научного обучения, обширна и имеет потенциал для исследования. Я призываю вас копнуть глубже, поэкспериментировать с наборами данных и узнать, как линейная регрессия может пролить свет на неизвестное, направлять стратегические решения и способствовать всеобщему благу.
Рекомендуемые статьи
Узнайте больше и усовершенствуйте свой путь в области науки о данных, прочитав другие наши подробные статьи на аналогичные темы.
- Что такое регрессионный анализ? Комплексное руководство для начинающих
- Как сообщить о результатах множественной линейной регрессии в стиле APA
- Как сообщить о результатах простой линейной регрессии в стиле APA
- Допущения в линейной регрессии: подробное руководство
- Как рассчитать остатки в регрессионном анализе?
- Линейный регрессионный анализ: построение линий в R
Часто задаваемые вопросы (FAQ):
В1: Как выполнить линейную регрессию с помощью Scikit?Используйте класс 'LinearRegression' из библиотеки scikit-learn для эффективного моделирования и прогнозирования взаимосвязей между независимыми и зависимыми переменными.
В2: Что такое показатель линейной регрессии?Показатель относится к коэффициенту детерминации R² прогноза, который измеряет долю дисперсии зависимой переменной, которую можно предсказать на основе независимой переменной (переменных).
В3: Как импортировать линейную регрессию в Python?Используйте `from sklearn.linear_model import LinearRegression` для импорта класса `LinearRegression` из модуля `linear_model` библиотеки scikit-learn.
В4: Что такое свободный член и коэффициент линейной регрессии в Python?Свободный член — это значение зависимой переменной, когда все независимые переменные равны нулю. Коэффициенты — это значения, которые умножают значения независимых переменных, отражая их взаимосвязь с зависимой переменной.
В5: Как интерпретировать коэффициенты линейной регрессии в Scikit-Learn?Коэффициенты показывают ожидаемое изменение зависимой переменной при изменении каждой независимой переменной на одну единицу, при условии, что другие переменные остаются постоянными.
В6: Что такое переобучение и как с ним бороться?Переобучение происходит, когда модель улавливает шум вместо скрытого паттерна. Такие методы, как перекрестная проверка и регуляризация в scikit-learn, помогают решить эту проблему.
В7: Может ли линейная регрессия обрабатывать категориальные переменные?Используя такие методы, как one-hot кодирование, категориальные переменные могут быть эффективно включены в модели линейной регрессии в scikit-learn.
В8: Как проверить модель линейной регрессии?Проверка включает в себя использование таких методов, как перекрестная проверка, и оценку показателей эффективности, таких как R² и RMSE, для обеспечения точности и надежности модели.
В9: Как можно повысить точность модели линейной регрессии?Повышение точности может включать в себя инженерию признаков, например, выбор релевантных переменных и применение методов регуляризации, таких как Ridge или Lasso, для уменьшения переобучения и повышения производительности модели.
В10: Каковы типичные практические применения линейной регрессии?Линейная регрессия широко применяется в прогнозировании (например, продаж и погоды), оценке рисков в финансах и страховании, а также в оценке тенденций и взаимосвязей в научных исследованиях, демонстрируя свою универсальность в различных областях.